Deep Insight 如何解决多智能体系统的 5 个生产挑战
5 production challenges in multi-agent systems and how Deep Insight solved them
AWS 团队以 Deep Insight 为例,讲解多智能体系统在执行编排、模型选择、生产运行、代码安全和运维监控上的 5 个挑战及解决方案。系统通过 8 个智能体协作,将 CSV 数据与自然语言请求转化为图表及带引用的 DOCX 报告,结合 Strands Agents SDK 的流程编排、人工计划审核和按角色配置的 Claude 模型组织任务。
通过把执行编排、模型分工、运行隔离与运维监控逐项对应到实现方案,文章提供了从多智能体原型走向生产的可迁移架构思路。
构建多智能体系统如今已相当简单。将其投入生产,才是真正挑战的开始。借助开源框架和云服务,你可以在几天内搭建一个智能体。几次工具调用、几行提示词,就能做出看起来令人印象深刻的成果。但当团队试图超越试点阶段,将其用于实际业务应用时,就会遇到一道熟悉的障碍。如果你曾尝试将智能体投入生产,以下这些令人头疼的问题一定不会陌生:
为什么智能体不遵循我们的业务逻辑、跳过验证步骤,或无法识别边界情况?
你调整提示词、添加更多示例、更换模型,同样的问题却反复出现。这是因为智能体并不遵循固定的指令序列,而是根据上下文自行作出判断。仅靠指令还不够。你需要设计智能体如何思考、何时验证,以及出错时如何处理。这正是为什么不能仅停留在提示词工程,而必须设计智能体的整个认知架构和执行流程。
为正面应对这些挑战,AWS 解决方案架构团队构建了生产级多智能体系统 Deep Insight。在这个由三篇文章组成的系列中,我们将分享团队在构建 Deep Insight 过程中的亲身经验。我们将逐步介绍如何在真实生产环境中应用 Anthropic 提出的上下文工程技术(多智能体架构、结构化笔记、人工参与等)。我们还将介绍沿途遇到的权衡取舍(附代码),以及在 AWS 上部署和运行该智能体所获得的运维经验。
博客系列概览
- 第 1 部分:多智能体系统的 5 项生产挑战,以及 Deep Insight 如何解决这些挑战。
- 第 2 部分:超越上下文窗口:上下文工程技术及 Deep Insight 的应用方式。
- 第 3 部分:Harness 工程实践:将 Deep Insight 从开发环境推向生产环境。
这是三篇系列文章中的第 1 部分。本文界定了任何生产级多智能体系统都必须解决的五项核心挑战,并展示技术栈的各个层级如何应对这些挑战,涵盖 Strands Agents SDK、Amazon Bedrock、Amazon Bedrock AgentCore、Application Load Balancer 和 AWS Fargate。第 2 部分和第 3 部分将介绍上下文工程和生产部署。
Deep Insight 简介
Deep Insight 是一个多智能体系统,能够将复杂的数据分析转化为自动生成的洞察。给定一个 CSV 文件和一段自然语言提示词,按层级组织的专业智能体(协调员、规划员、监督员、编码员、验证员、报告员和跟踪员)便会协同开展分析。它们共同加载数据、运行分析、生成图表、验证计算结果,并生成带有引用的专业报告(.docx)。
我们将在后文详细探讨其架构。首先,来看看它的实际表现。在演示中,我们输入一家虚构食品公司 Yummy Food 的广告数据(yummy-food-market.csv)和列定义文件(column_definitions.json),并提供以下提示词:从销售和营销角度分析这些数据,生成图表和洞察,并生成一份 .docx 报告。Deep Insight 会生成分析计划,提交给用户审批,并在获批后执行分析。
| 内容 | |
| 输入 | CSV 数据文件(yummy-food-market.csv)+ 列定义文件(column_definitions.json) |
| 示例提示词 | “从销售和营销角度对此进行分析,生成图表和洞见,并制作一份 .docx 报告。” |
| 输出 | DOCX 报告(两个版本,一个带引用,一个不带引用)及图表图片(PNG) |
下面的 Deep Insight Web 演示视频展示了完整的工作流程,从上传数据、审查分析计划,到实时流式输出和下载完成的报告。
如何试用?
Deep Insight 已在 GitHub 上开源,提供完整的设置指南,并提供涵盖从开发到生产的三种部署选项。
第一种是自托管版本,通过 CLI 在本地运行。它针对快速迭代进行了优化,可在代码层面全面访问每个智能体、提示词和工作流。设置大约需要 10 分钟,因此非常适合开发。(YouTube 上提供自托管版本的演示视频。)
第二种是 Web 版本,它提供基于浏览器的 UI,用于上传数据、审查分析计划(人在回路,简称 HITL)和下载报告,全程无需编写代码,非开发人员也能使用。(前面的演示视频展示了 Web 版本的实际运行过程。)
第三种是托管式 AgentCore 版本,这是一种由 Amazon Bedrock AgentCore 提供支持的生产部署选项。Amazon Bedrock AgentCore 是一个支持使用任意框架或模型大规模构建、连接和优化智能体的平台。此版本将智能体部署在 AgentCore 运行时上,这是 Amazon Bedrock AgentCore 的一项功能。系统完全运行在私有虚拟私有云(VPC)内,自定义代码解释器单独托管在 AWS Fargate 上,智能体则在按用户隔离的环境中并发运行。当您需要会话隔离和私有 VPC 部署时,这是合适的选择。第 3 部分将详细介绍其部署和运维。
这三种版本采用相同的多智能体架构,因此在开发环境中通过验证的智能体可以原样部署到生产环境。
解决方案概述
构建生产级多智能体系统,光有好的提示词还不够。您需要合适的技术栈和基础设施,来解决智能体如何协作、如何推理、如何部署、在哪里安全执行代码,以及如何监控运行状况等问题。Deep Insight 解决了这五个关键领域的问题。由于智能体既生成代码,也生成报告内容,我们还将在解决方案详解 2 中介绍生产环境中的负责任 AI 管控措施。
| 挑战 | 技术 | 方法 |
| “如何控制多个智能体之间的执行流程?” | Strands Agents SDK | 使用 Strands 的 Graph 模式定义智能体之间的执行顺序,并实现人在回路的分支流程。使用 Strands 的 Agents as Tools 模式,使 Supervisor 能够按需将专用智能体(Coder、Validator、Reporter、Tracker)作为工具调用。 |
| “每个智能体应该使用哪种大语言模型(LLM)?” | Amazon Bedrock | 为每个角色选择合适的 Claude 模型:Haiku 用于基本路由,Opus 用于规划,Sonnet 用于执行。 |
| “如何在生产环境中可靠地运行开发完成的智能体?” | Amazon Bedrock AgentCore | 提供监控、会话隔离和私有 VPC 部署的托管运行时。 |
| “如何缓解执行 AI 生成代码带来的安全问题?” | AWS Fargate + Application Load Balancer (ALB) | 为每个会话提供临时沙箱容器,通过自定义代码解释器实现隔离的代码执行。 |
| “如何监控和管理系统?” | Amazon DynamoDB + Amazon Simple Notification Service (Amazon SNS) + Amazon Cognito | 管理仪表板和故障告警系统。 |
以下架构图(图 1)直观展示了这一方案。绿色方框代表 Strands Agents 多智能体结构,用于应对上表中的挑战 1 和 2。我们将在接下来的“方案详解 1:多智能体系统设计”一节中详细介绍。图中其余基础设施组件用于应对挑战 3、4 和 5,我们将在“方案详解 2:生产部署与运维”中逐一讲解。
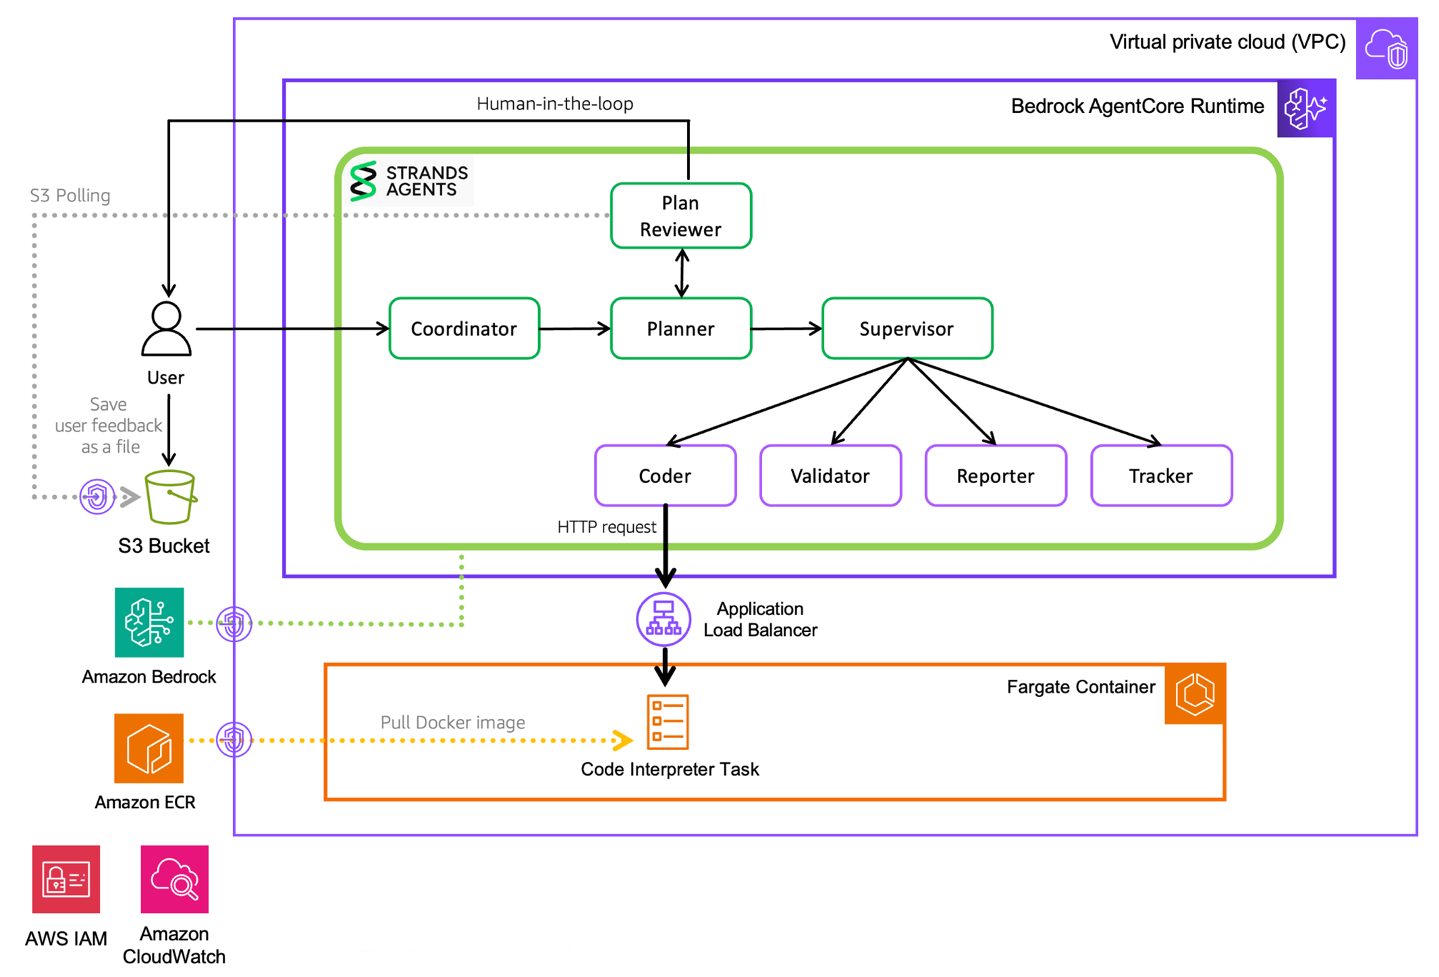
图 1:解决方案架构
方案详解 1:多智能体系统设计
Deep Insight 采用多智能体架构,由八个智能体协作产出一份高质量的交付成果。每个智能体都在各自独立的上下文中工作,仅执行其专门负责的任务,并且只向后续智能体传递压缩后的结果。
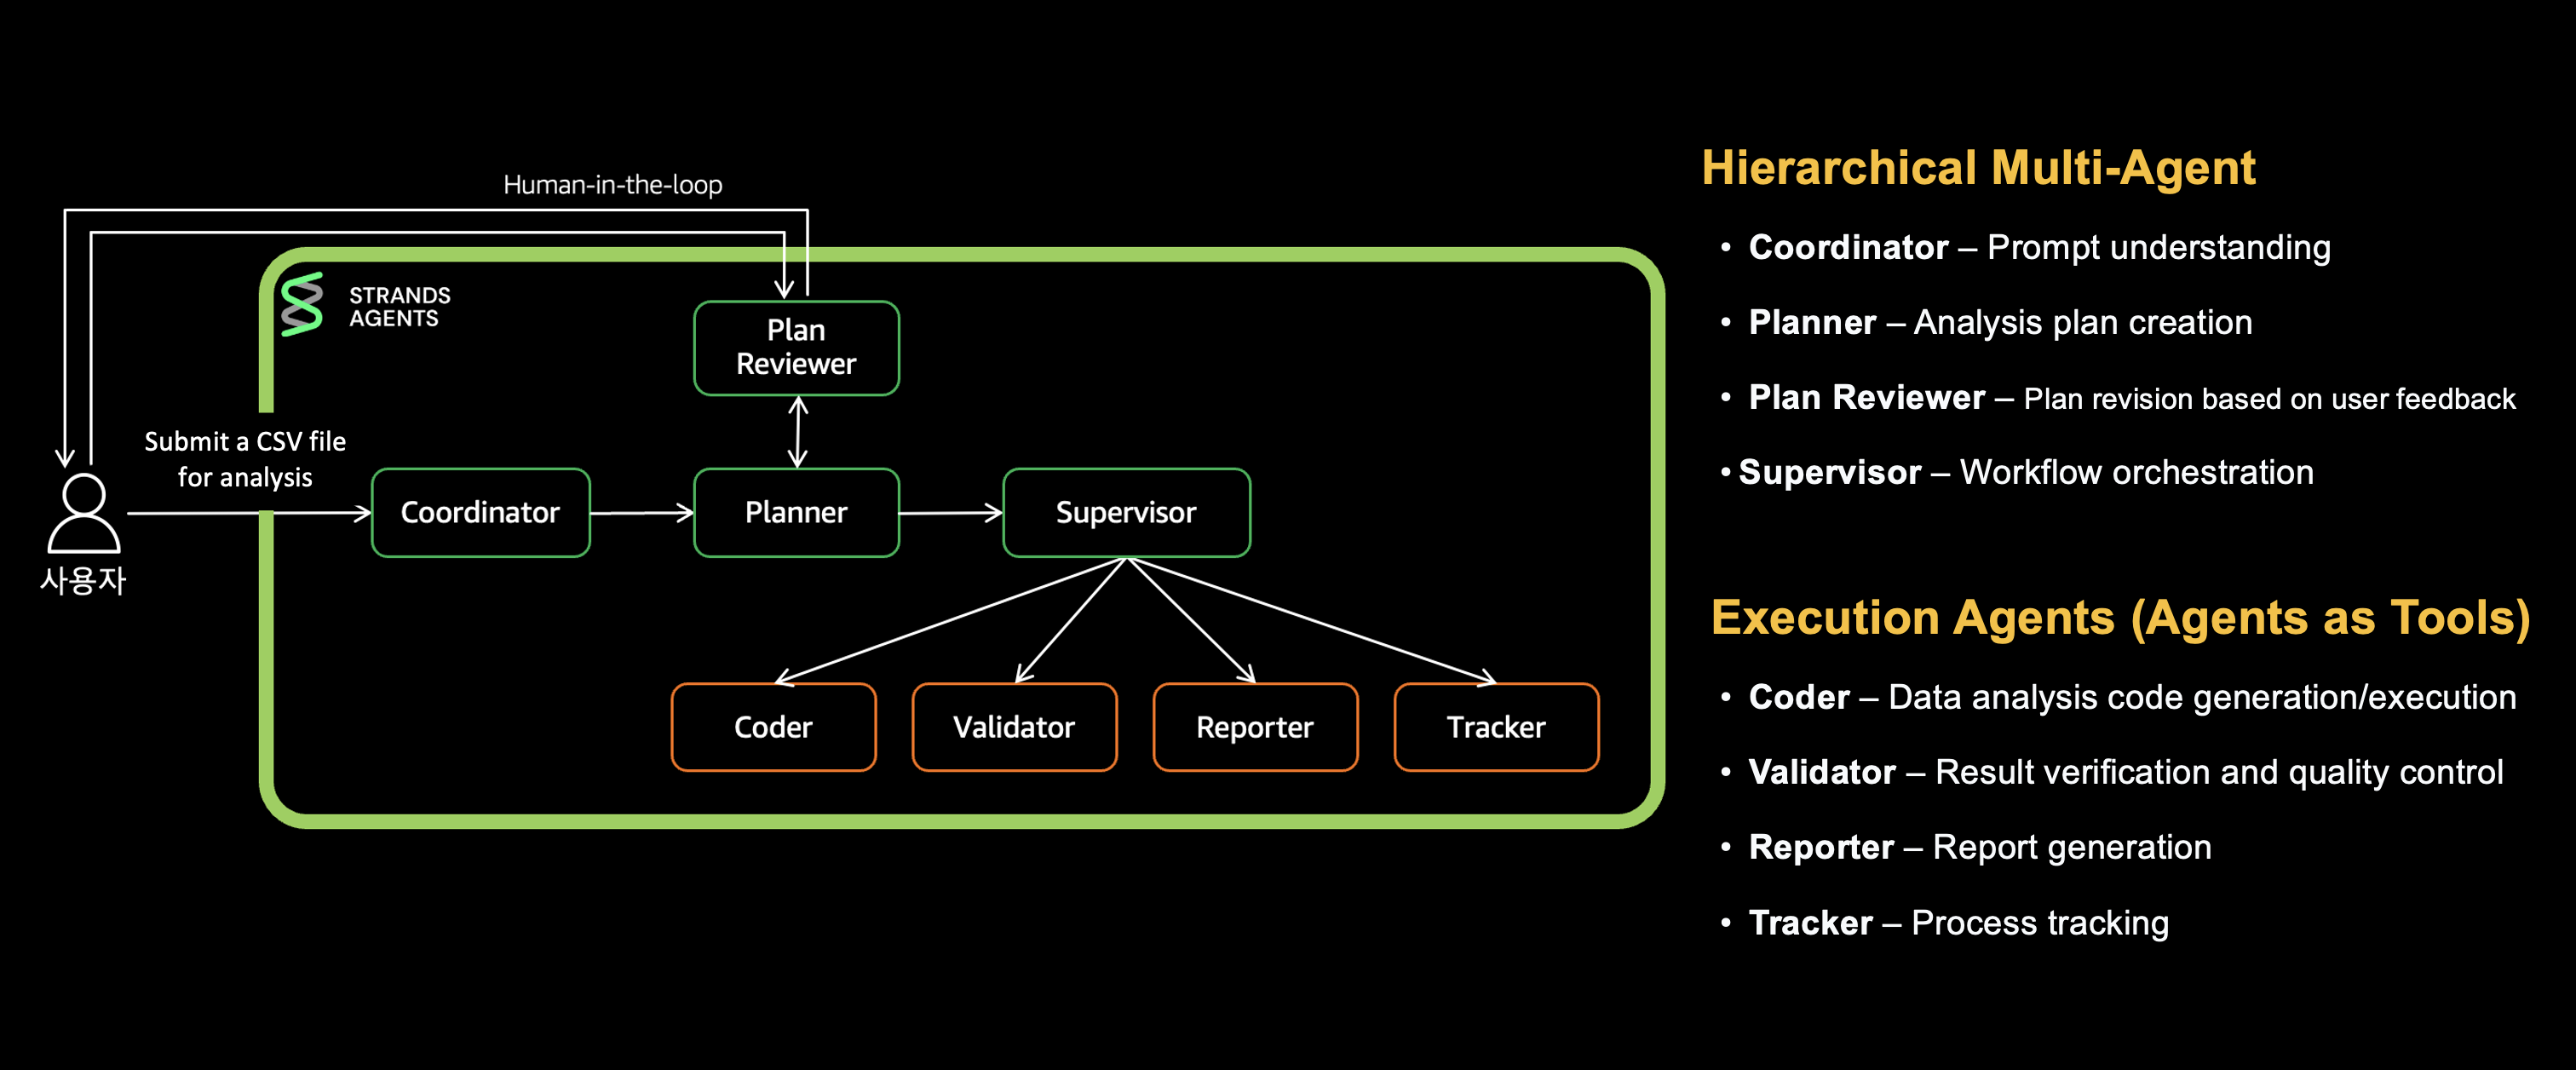
图 2:多智能体结构
Coordinator 负责路由用户请求,Planner 将任务拆分为独立步骤,Plan Reviewer 收集用户反馈,Supervisor 根据计划调用相应的专用智能体。Coder 编写并执行数据分析代码,Validator 验证计算结果,Reporter 生成最终报告,Tracker 跟踪进度。我们将分三个层次进行说明:
- [第 1 层] Coordinator 到 Planner 再到 Plan Reviewer:请求分析与执行计划制定。
- [第 2 层] Supervisor:专用智能体编排。
- [第 3 层] Coder、Validator、Reporter、Tracker:专门任务执行。
我们结合使用 Strands Agents SDK 的两种关键模式,控制这些智能体之间的执行流程。首先,图模式以有向图定义智能体的执行顺序和流程。请求依次流经 Coordinator、Planner、Plan Reviewer,然后到达 Supervisor;如果收到修改请求,则通过条件分支循环返回 Planner。根据条件确定下一步操作,让 HITL 和错误处理等复杂工作流变得简单直接。其次,智能体即工具模式让 Supervisor 仅在需要时将专用智能体(Coder、Validator、Reporter、Tracker)作为工具调用。每个智能体都在独立的上下文中工作,并且只返回结果,从而在保留领域专业能力的同时,最大限度地减少上下文用量。
本节展示该架构如何解决路由、规划和编排问题。
[第 1 层] Coordinator 到 Planner 再到 Plan Reviewer
这一层将用户请求转化为经过批准的执行计划。
1.1 Coordinator(路由):并非每个请求都需要高成本的编排
Coordinator 是用户请求的入口。它直接处理简单的问候,并通过 handoff_to_planner 标记将数据分析等复杂任务路由至 Planner。
关键的设计决策在于模型选择:由于 Coordinator 只负责分类,因此使用轻量级的 Claude Haiku,避免在简单问候上产生 Opus 级别的成本,同时实现快速响应。
# builder.py: conditional edges for routing decisions
builder.set_entry_point("coordinator")
builder.add_edge("coordinator", "planner", condition=should_handoff_to_planner)
路由条件来自 Coordinator 的提示词:任何需要工具、推理或多步骤思考的请求都会转交给 Planner。
1.2 Planner(计划制定):复杂分析需要在执行前进行拆解
在 Deep Insight 的多智能体架构中,Planner 智能体承担着在各智能体之间分配任务的关键职责。在实质性工作开始之前,它会将大型任务拆分为较小的步骤,再由各个专门的智能体逐一执行,使每个智能体的上下文保持精简。
Planner 使用开启了 Extended Thinking 的 Claude Opus 模型来制定分析计划。它将计划组织成 [ ] 检查清单格式,明确分配给每个智能体的具体任务,并存储在 full_plan 变量中。它将请求拆分为 5–10 个清晰的步骤,如下例所示:
## title
Yummy Food Consumer Purchase Patterns and Advertising Effectiveness Analysis Report

## steps

### 1. Coder: Comprehensive Data Analysis and Insight Generation
- [ ] Load all data files from './data/*' path and understand structure
- [ ] Analyze consumer purchase history (patterns, preferences, customer segments)
- [ ] Analyze advertising data by channel (cost, effectiveness, channel comparison)
- [ ] Category-level analysis (fresh food, convenience food, health food ad effectiveness)
- [ ] Calculate key business metrics (conversion rate, CPA, ROAS, etc.)
- [ ] Generate visualizations (5+ charts, consumer segment charts)
- [ ] Derive strategic marketing insights
- [ ] Generate calculation metadata (for validation)

### 2. Validator: Calculation Verification and Citation Metadata Generation
- [ ] Identify verification targets and extract filter calculations
- [ ] Load data files directly and perform recalculations
- [ ] Verify accuracy of per-channel performance metrics
- [ ] Validate data consistency of visuals and graphs
- [ ] Generate citation metadata (reference numbers for verified items)

### 3. Reporter: Marketing Analysis Report Generation
- [ ] Write report overview
- [ ] Create structured report using verified analysis results
- [ ] Insert visualizations and analysis sections
- [ ] Present marketing strategy recommendations and improvement proposals
- [ ] Generate professional marketing report in DOCX format
1.3 计划审核器
Plan Reviewer 是一个人在回路(HITL)节点,负责向用户展示计划并收集批准或修改反馈。如果收到反馈,它会返回 Planner 修改计划。如果获得批准,则将任务移交给 Supervisor。系统设置了最大修改次数(MAX_PLAN_REVISIONS),以防止无限循环。
# builder.py: Plan Reviewer's bidirectional conditional edges
builder.add_edge("plan_reviewer", "planner", condition=should_revise_plan)
builder.add_edge("plan_reviewer", "supervisor", condition=should_proceed_to_supervisor)
builder.set_max_node_executions(25)
在 Web 版本中,Plan Reviewer 会显示一个浏览器模态框,用户可在其中阅读并批准计划,或输入修改反馈。如果未收到响应,300 秒倒计时结束后会自动批准计划。
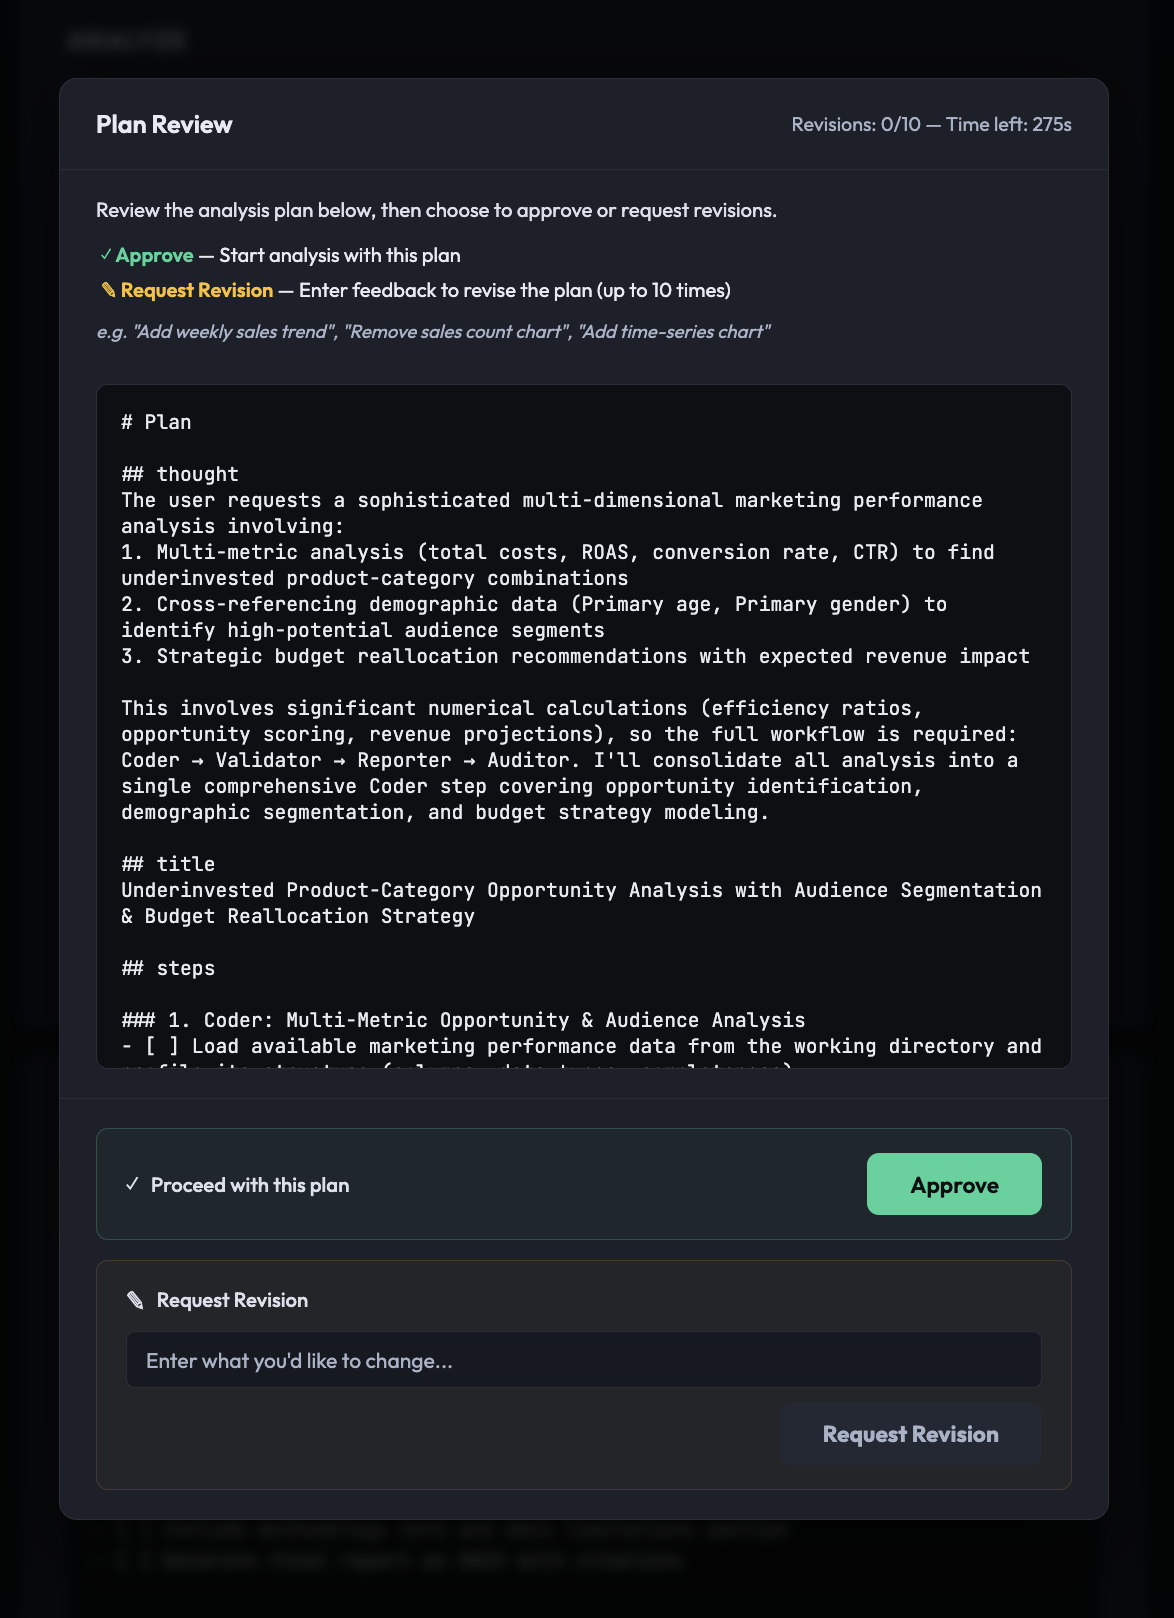
图 3:Plan Reviewer 智能体在 Web 界面中的执行过程
没有规划时,智能体会在运行时决定一切,中途调整会使之前的工作失效,用户也无法了解进度。有了 Planner 和 Plan Reviewer,用户就可以审核和修改计划、实时监控进度,并仅重新执行失败的步骤。
[第 2 层] Supervisor(编排器):专门的智能体需要一位指挥
Supervisor 按顺序执行 Planner 的 full_plan,通过 Tool Use 调用注册为其工具的第 3 层智能体(Coder、Validator、Reporter、Tracker)。
# nodes.py: registering sub-agents as tools on the Supervisor
agent = strands_utils.get_agent(
    agent_name="supervisor",
    system_prompts=apply_prompt_template(prompt_name="supervisor", prompt_context={}),
    model_id=os.getenv("SUPERVISOR_MODEL_ID", os.getenv("DEFAULT_MODEL_ID")),
    prompt_cache_info=(True, "default"),
    tool_cache=True,
    tools=[coder_agent_tool, reporter_agent_tool, tracker_agent_tool, validator_agent_tool],
    streaming=True,
)
Supervisor 的系统提示词定义了严格的工作流规则:
- 强制执行顺序:Coder、Tracker、Validator、Tracker、Reporter、Tracker:每个智能体运行后,都会调用 Tracker 跟踪进度,让 Supervisor 能够管理整体任务状态。
- 阶段完成规则:只有当前智能体的所有检查清单项都标记为 [x] 后,Supervisor 才会转到下一个智能体。
- 上下文保留:Supervisor 将 clues 和 full_plan 变量传递给每个工具智能体,以保持完整上下文并防止信息丢失。
[第 3 层] Coder、Validator、Reporter、Tracker:分工提升质量
每个第 3 层智能体(Coder、Validator、Reporter、Tracker)都被封装为一个 PythonAgentTool,并接收来自 Supervisor 的 Tool Use 调用。每个智能体都在 Strands SDK 中被创建为独立的 Agent() 实例,拥有自己的系统提示词、模型 ID 和工具集。
| 智能体 | 职责 | 工具 | 主要输出 |
| Coder | 数据分析、图表生成、洞见提炼 | write_and_execute_tool, bash_tool, file_read, skill_tool | *.png 图表、calculation_metadata.json |
| Validator | 数值计算复核、引用生成 | write_and_execute_tool, bash_tool, file_read | citations.json, validation_report.txt |
| Reporter | DOCX 报告生成 | write_and_execute_tool, bash_tool, file_read | final_report.docx, final_report_with_citations.docx |
| Tracker | 检查清单进度状态更新 | 无(仅使用 LLM 推理) | 更新后的 full_plan |
Supervisor 根据 Planner 的检查清单,按以下顺序发起 Tool Use 调用:
- Coder – 加载数据,编写并运行分析代码,生成 PNG 图表,将结果累积保存到 all_results.txt 中,并留下
calculation_metadata.json以供验证。 - Tracker(第 1 次)– 将已完成的检查清单项从 [ ] 更新为 [x],Supervisor 据此决定是否继续。
- Validator – 根据源数据重新执行
calculation_metadata.json中的每项计算。误差在 0.01 以内则通过,不匹配的结果会被标记。已验证的计算结果存入citations.json,供 Reporter 引用。 - Tracker(第 2 轮)– 在检查清单中反映 Validator 的完成状态。
- Reporter – 读取 all_results.txt 和
citations.json,生成带引用和不带引用两个版本的最终 DOCX 报告。 - Tracker(第 3 轮)– 反映所有任务的最终完成状态。
Tracker 在每个智能体运行后运行,以便 Supervisor 跟踪进度并强制执行完成规则(所有项目均标记为 [x] 后才能继续)。由于它通过 LLM 推理更新检查清单,不使用工具,因此增加的开销很小。
各智能体的 LLM 模型配置
Deep Insight 根据每个智能体的角色定制模型和设置。这不只是模型选择,而是为优化成本和质量所做的架构决策。
| 智能体 | 模型 | 扩展思考 | 提示词缓存 | 角色 |
| Coordinator | Haiku | 禁用 | 否 | 快速路由:最大限度降低成本 |
| Planner | Opus | 启用(~8,192 tokens) | 否 | 深度思考:高质量规划 |
| Supervisor | Sonnet | 禁用 | 是 | 执行编排:通过缓存节省成本 |
| Coder | Sonnet | 禁用 | 是 | 代码生成/执行:缓存对重复调用有效 |
| Validator | Sonnet | 禁用 | 否 | 数值验证:每次数据不同,无需缓存 |
| Reporter | Sonnet | 禁用 | 是 | 报告生成:缓存对长提示词有效 |
| Tracker | Sonnet | 禁用 | 否 | 状态更新:轻量级任务,无需缓存 |
Supervisor、Coder 和 Reporter 智能体使用提示词缓存来缓存其系统提示词和工具定义,在重复调用时可将输入 token 成本最多降低 90 percent。Coordinator 仅运行一次,而 Validator 和 Tracker 每次运行时的上下文都不同,因此缓存对它们无效,保持禁用。这种选择性缓存策略是经过审慎考虑的成本与性能权衡。
方案详解 2:生产部署与运维
如果说方案详解 1 定义了系统做什么,那么本节则定义了系统在何处以及如何安全运行。从这里开始的所有内容都涉及生产运维的基础设施决策。具体而言,本节涵盖 LLM 生成代码的安全执行环境,以及团队所需的运维可观测性。
1. 代码执行:LLM 生成的代码需要安全的执行环境
Coder 智能体编写并运行 Python 代码以进行数据分析。在自托管版本中,它通过 subprocess.run() 在本地运行,但在生产环境(AgentCore)中,安全性和隔离至关重要。直接在生产服务器上运行 LLM 生成的代码存在风险:模型可能删除系统文件、因无限循环耗尽资源,或访问其他用户的分析数据。Deep Insight 通过 AWS Fargate 和 ALB 上按会话创建的临时容器解决这一问题。这些组件并非各自孤立运行。如图 1 所示,AgentCore 运行时、ALB 和 Fargate 任务都在同一个私有 VPC 内运行。VPC 端点将它们连接到 Amazon Simple Storage Service(Amazon S3)、Amazon Bedrock 和 Amazon Elastic Container Registry(Amazon ECR),无需经过公共互联网。安全组限制哪些组件可以访问 Code Interpreter 容器。AWS Identity and Access Management(IAM)角色将各组件的访问权限限定为其所需的 AWS 资源。Amazon CloudWatch 收集容器日志,以及来自 Amazon Bedrock AgentCore 的一项功能 AgentCore Observability 的可观测性数据。
- 自定义容器 Docker 镜像:预先优化的沙箱,包含多智能体系统所需的字体、系统库和 Python 包。
- 容器隔离:每个分析会话都会获得一个独立的 Fargate 容器,位于私有 VPC 子网中,无法直接访问互联网。
- 2 步执行:LLM 生成的代码经过 base64 编码,通过 HTTP 发送并写入文件(步骤 1),然后通过 subprocess 执行(步骤 2)。
- 会话亲和性:即使智能体多次执行代码,ALB 粘性会话 Cookie 也会将其路由回同一个容器。
- 产物管理:分析完成后,图表、报告和日志会上传到 Amazon S3。容器会在一小时后自动终止。
容器隔离可以保护基础设施,但无法管控智能体生成的内容。Validator 智能体会重新验证计算结果。它不会检测上传数据中隐藏的提示注入指令,也不会筛查 LLM 生成的文本中是否包含有害或缺乏依据的内容。对于生产部署,我们建议添加 Amazon Bedrock Guardrails 作为负责任 AI 的管控措施:对用户提示和上传的数据应用内容过滤和提示攻击检测,并对智能体输出应用上下文依据检查,确保报告文本始终以源数据和经过验证的计算结果为依据。
2. 运维与监控:团队需要可见性
仅有代码并不能构成完整的生产系统。团队必须评估系统健康状况、诊断问题并审查结果,因此 Deep Insight 提供了 Web 界面和运维仪表板。
Web 界面(deep-insight-web)
基于 FastAPI 的 Web 界面,通过 AgentCore 原生协议(boto3.invoke_agent_runtime())与后端通信。用户上传数据并输入提示,然后通过服务器发送事件(SSE)流监控进度。计划生成后,用户可以通过模态对话框批准计划或提供修改反馈(HITL)。完成的报告可直接下载。同时支持韩语和英语。
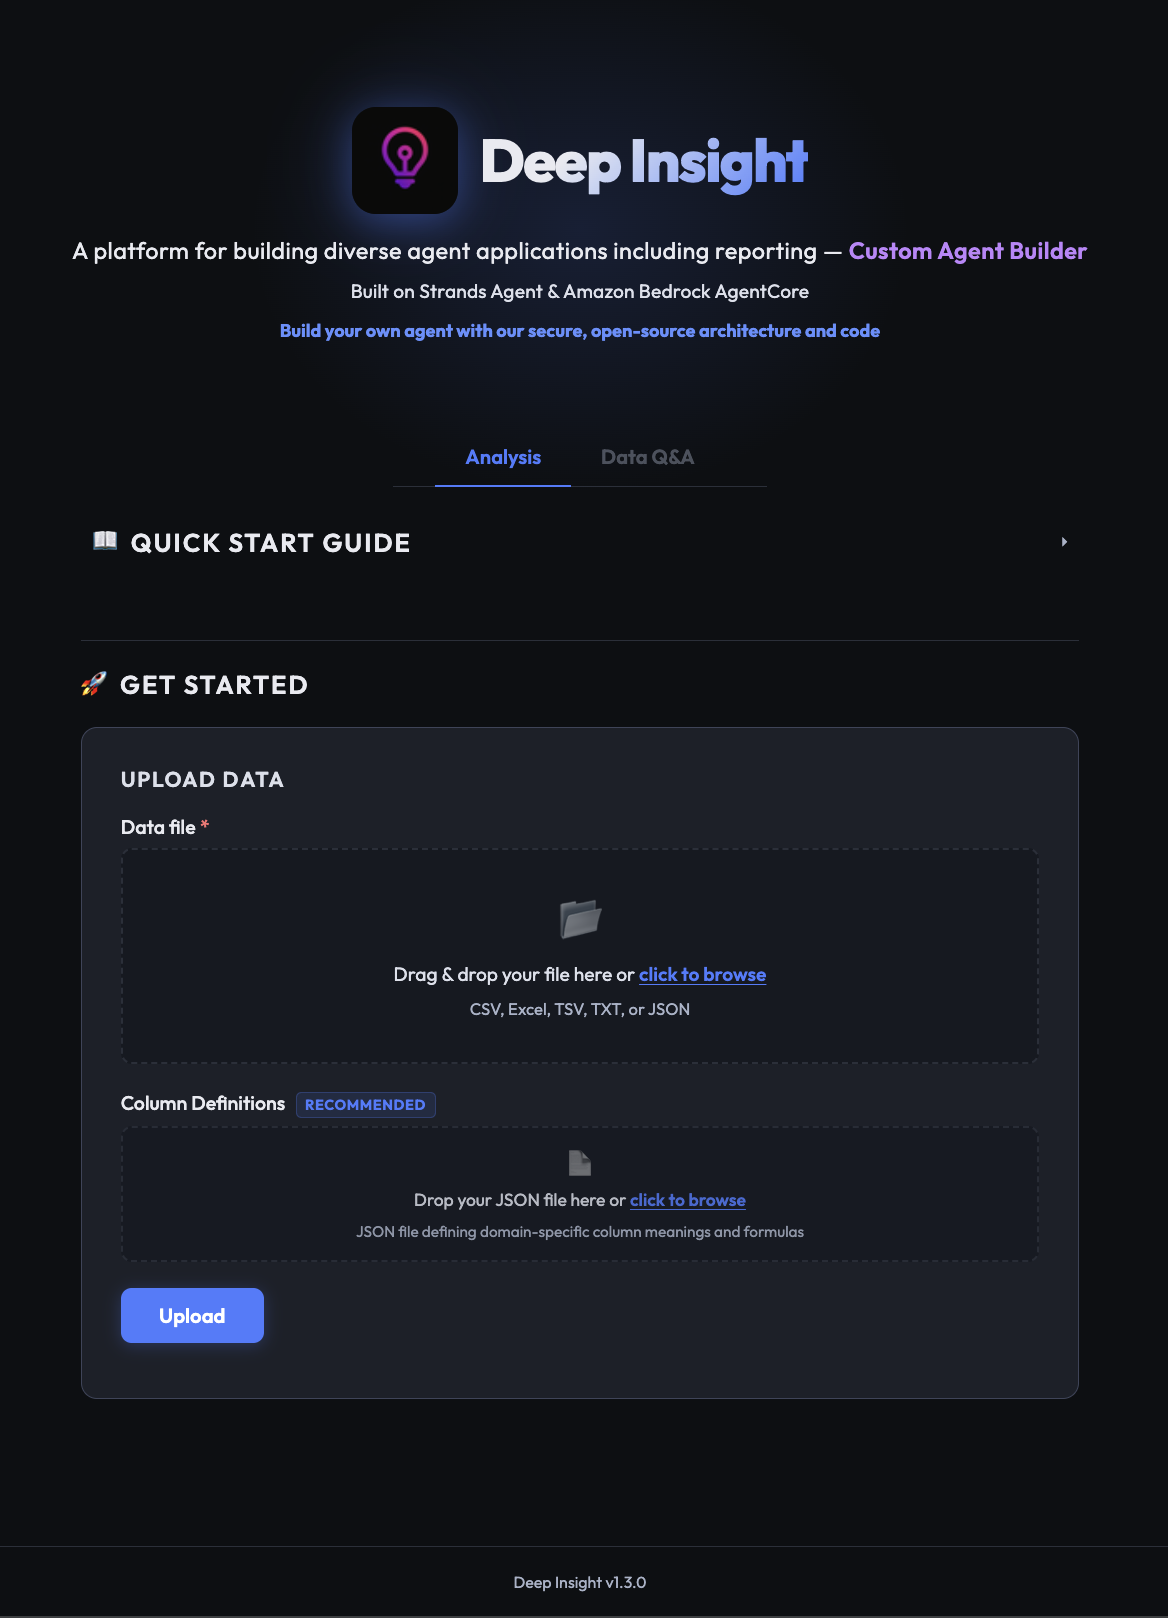
图 4:Deep Insight Web 版本截图
运维仪表板(deep-insight-web/ops)
运维仪表板是可选的。没有它,Deep Insight 也能正常运行,但它可为有需要的团队提供以下功能:
- 任务跟踪:所有分析任务指标,包括状态、token 用量和耗时,都会记录在 Amazon DynamoDB 中。
- 故障告警:分析失败时,会立即通过 Amazon SNS 向管理员发送电子邮件。
- 管理仪表板:专用管理仪表板通过 Amazon Cognito 的 JSON Web Token(JWT)身份验证进行保护,以实现安全的任务监控。
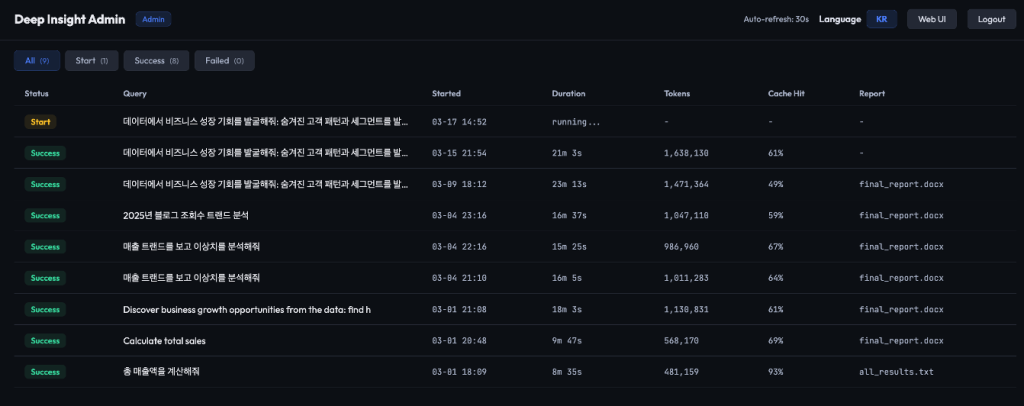
图 5:Deep Insight 运维仪表板截图
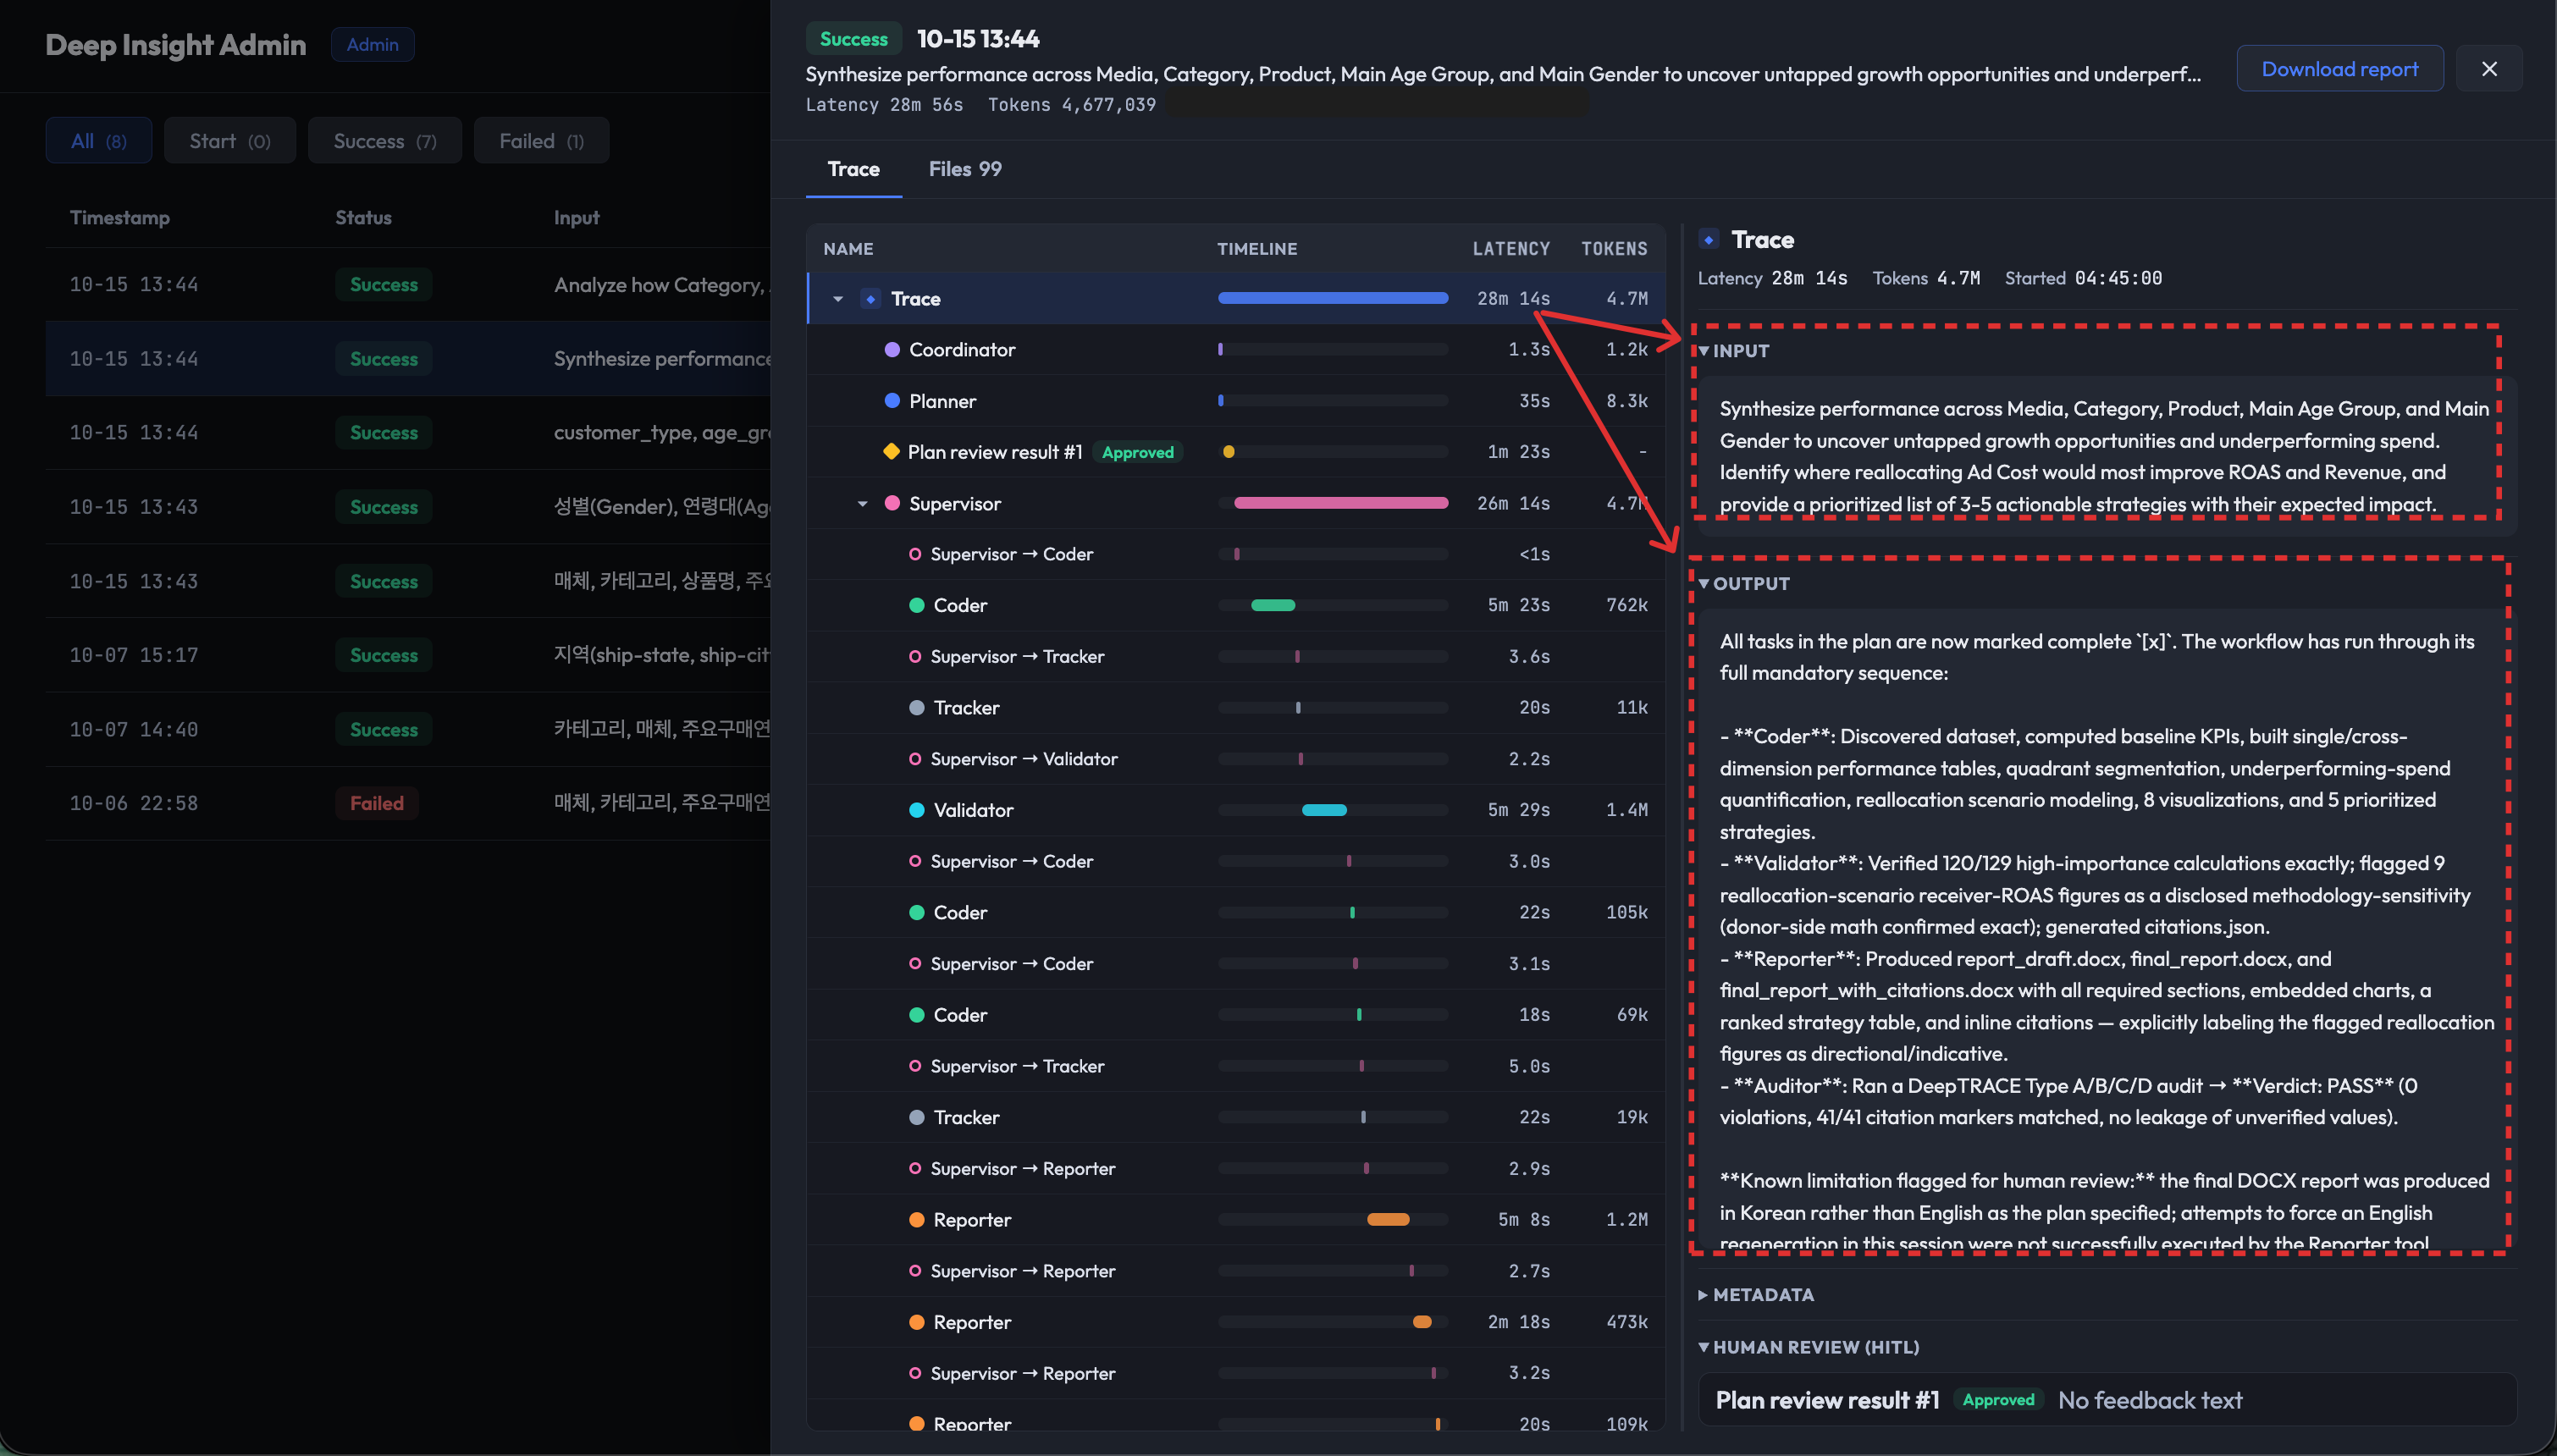
图 6:Deep Insight 运维仪表板详细视图
扩展 Deep Insight 架构
Deep Insight 的多智能体架构并不局限于数据分析报告生成这一单一领域。以下两个示例表明,分层编排设计原则在完全不同的领域中仍然有效。
案例 1:LG Electronics:由智能体 AI 驱动的营销洞察提取系统
LG Electronics 韩国销售部门基于与 Deep Insight 相同的多智能体架构构建了 ChatInsight。此前,数据分析请求需要 2–3 周才能完成,而且在营销人员与数据科学家之间传递时会丢失原始意图。Coordinator 根据复杂程度进行路由,Planner 跟踪任务,Supervisor 则编排 Coder 和 Reporter,智能体之间的状态通过 all_results.txt 文件累积传递。过去需要 3 天的分析现在只需 30 分钟,生产力提升了 288 倍。不了解 SQL 的营销人员可以让智能体探索数据并提出策略(参见 AWS 技术博客上的 LG Electronics 智能体 AI 洞察提取系统)。
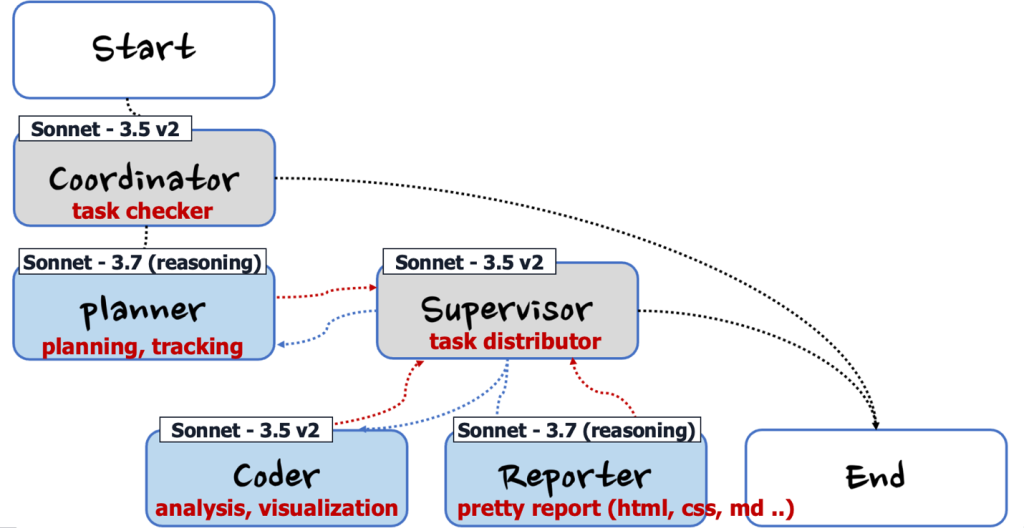
图 7:LG Electronics 智能体 AI 营销洞察系统架构
案例 2:TechRecon:AI 驱动的技术侦察智能体(re:Invent 2025)
在 AWS re:Invent 2025(会议场次 SNR203)上展示的 TechRecon 将 Deep Insight 的架构应用于技术战略。给定一家公司和所属行业后,Researcher 收集技术趋势,Coder 进行分析,Validator 进行验证,Reporter 则生成一份全景分析报告和一份技术立场文件。该架构与 Deep Insight 几乎完全相同,使用 Strands Agents SDK 的 Graph 模式以及扩展思考和提示词缓存构建,只是由 Researcher 取代 Coder 作为主要执行智能体。这表明该设计是一种通用模式:替换智能体的角色和提示词,同样的编排结构就能解决完全不同的问题。
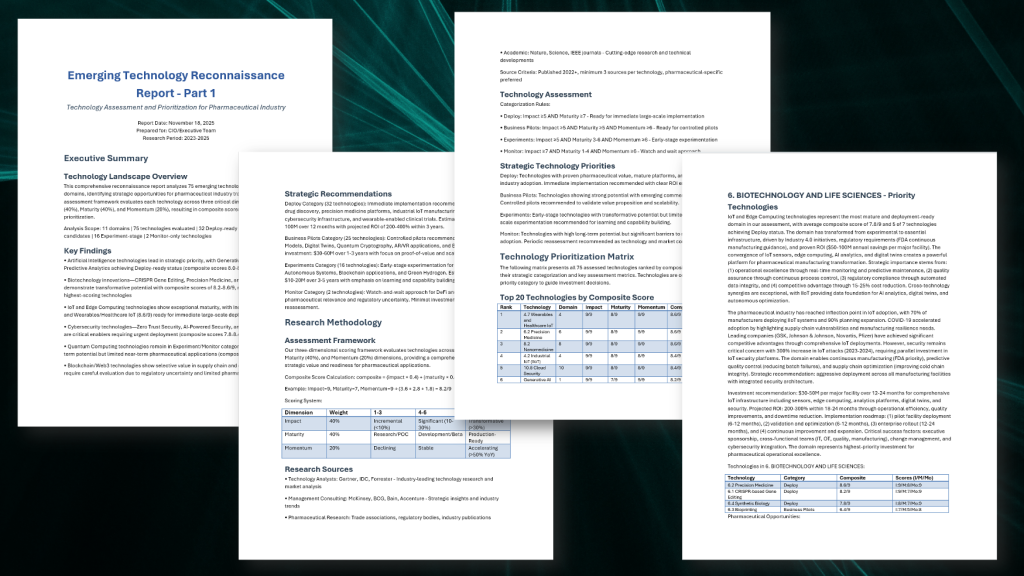
图 8:TechRecon 结果
(了解更多:TechRecon GitHub | AWS re:Invent 会议视频)
结论
构建能够在生产环境中运行的智能体,关键不在于模型能力,而在于架构。Deep Insight 提供了一个经过验证的答案:
- 工作流管理:Strands Agents SDK 的 Graph 模式定义智能体之间的执行顺序并实现 HITL 分支,而 Agents-as-Tools 模式则让 Supervisor 仅在需要时调用专用智能体。
- 推理引擎:我们按角色分配 Amazon Bedrock 中的 Claude 模型(依次为 Haiku、Opus、Sonnet),以优化成本和质量。
- 部署:Amazon Bedrock AgentCore 提供托管运行时,具备会话隔离、私有 VPC 部署和 OpenTelemetry 可观测性。
- 代码执行:Application Load Balancer 配合运行在 Fargate 上的 Amazon Elastic Container Service(Amazon ECS),将 LLM 生成代码的执行隔离在每个会话各自的临时沙箱容器中,防止系统文件访问、资源耗尽和意外数据泄露等安全问题。
- 运维:Web UI 的 SSE 流式传输和运维仪表板(DynamoDB + Cognito + SNS)为整个团队提供可见性。
LG Electronics 的营销洞察系统和 re:Invent 2025 上的 TechRecon 案例验证了这些设计原则。
在第 2 部分中,我们将在这一架构的基础上,探讨用于突破上下文窗口限制的四个层面的上下文工程技术,从架构级隔离到提示词设计、工具优化和验证保障,并将我们的方法与 Anthropic 的工程研究进行比较。
Deep Insight 已开源。探索其代码,并将其扩展到你自己的领域。
关于作者

Yoonseo Kim
Yoonseo 是一名解决方案架构师,帮助客户使用 AWS 技术解决业务挑战。她对 AI/ML 有着浓厚的兴趣,专注于帮助客户设计和优化智能体 AI 工作负载,以及配套的基础设施和评估环境。

Jesam Kim
Jesam 是一名解决方案架构师,帮助企业客户采用云技术并解决业务挑战。他专注于 AI/ML,包括推荐系统和生成式 AI,帮助客户设计满足其业务需求的架构。

Jiyun Park
Jiyun 是一名解决方案架构师,帮助软件和互联网行业的客户将工作负载迁移到云端。她与客户合作设计云解决方案,帮助他们实现业务目标。

Kyutae Park
Kyutae 博士 是一名 AI 专家解决方案架构师,凭借在机器学习、MLOps 和智能体 AI 方面的丰富经验,帮助各行业客户设计和构建应用型 AI 工作负载。他专注于通过智能体 AI 实现智能自动化和运营创新,将自主决策和多智能体协作架构引入实际业务环境。通过这些工作,他帮助客户利用 AWS AI/ML 服务和生成式 AI 应用取得切实的业务成果,并建立可持续的竞争优势。

Gonsoo Moon
Gonsoo 是 AWS 的一名 AI/ML 专家解决方案架构师。凭借在各种 AI/ML 用例和生产部署方面的经验,他与客户紧密合作,解决他们面临的 AI/ML 挑战。他还与数据科学家、开发人员和分析师分享 AI/ML 知识,致力于为韩国及世界各地的积极变革作出贡献。

Chloe Kwak
Chloe 是 Amazon Web Services 韩国零售团队的一名高级解决方案架构师。她帮助韩国的零售和电子商务客户设计可扩展、经济高效的云架构,并采用 AI/ML 服务,加速实现业务成果。
来源:AWS Machine Learning Blog · aws.amazon.com