AWS 教程:用 CDK 在 Amazon Bedrock Managed Knowledge Base 上构建智能体检索
Build agentic retrieval on a Managed Amazon Bedrock Knowledge Base with CDK
AWS 介绍如何用 Python CDK 在 Amazon Bedrock Managed Knowledge Base 和 AgentCore 上构建企业级智能体检索系统。
文章把多知识库路由、AgenticRetrieveStream、可观测性和评估整合进一套可部署的 CDK 实践,便于理解企业级智能体检索的工程结构。
本文介绍如何使用 AWS Cloud Development Kit(AWS CDK),基于 Managed Amazon Bedrock Knowledge Base 构建企业级智能体检索。要理解为什么值得构建,最好先从普通检索增强生成(RAG)的局限说起。大多数 RAG 系统都从同样的方式开始:将问题转换为嵌入向量,从一个索引中获取最近的文本块,将它们交给模型,然后返回答案。一次检索,一次生成。对于大量问题而言,这是正确的设计,也没有理由构建更复杂的系统。
它会以一种可识别的方式失效。提出一个答案跨越两个语料库的问题时,单次检索只能返回模型所需信息的一半,这比什么都不返回更糟,因为最终答案读起来流畅,却并不完整。提出一个正确来源取决于问题本身的问题时,单个索引没有选择机制。提出一个在看到第一次结果后还需要再次查看语料库的问题时,也没有地方执行这次二次检索。
企业级智能体检索通过将推理智能体置于流程中,解决了上述三个问题。智能体会决定是否进行检索、查询哪个知识库,以及在组织答案之前是否需要获取更多信息。这正是 Amazon Bedrock Knowledge Bases 的发展方向。随着 Managed Knowledge Base 的推出,检索不再是单次嵌入并获取的调用,而是成为一种智能体能力:多轮规划、工具驱动的检索,以及有依据并带引用的答案。AgenticRetrieveStream API 将这些能力作为一项开箱即用的服务功能提供,而不是需要自行组装的功能。这种方式确实可行,但也带来了一个真正更棘手的运营问题。单次执行管道是一个通过阅读代码就能分析的函数。会循环进行推理和检索的智能体,在面对每个问题时都会采取不同路径。默认情况下,你既看不到它采取了什么路径,也不知道它生成的答案是否可靠。可观测性不再是锦上添花,而是判断系统是否正常工作的唯一方式。
2024 年 8 月,Build an end-to-end RAG solution using Knowledge Bases for Amazon Bedrock and the AWS CDK 将单次执行设计部署为一个 CDK 应用:包含 Amazon Simple Storage Service(Amazon S3) 语料库、一个 Amazon OpenSearch Serverless 集合和索引、一个知识库以及一个数据源,并将它们配置为 CDK 堆栈,堆栈顺序由你手动编排。自该文章发布以来,有三项变化。
- Amazon Bedrock 现在提供托管式知识库(Type: MANAGED),由其自行负责摄取、存储、索引和检索。该文章配置的 OpenSearch Serverless 集合和索引不再需要你创建、扩展,也不再需要为其支付 OpenSearch Compute Units(OCUs)费用。
- Amazon Bedrock AgentCore 提供了智能体部分,包括一个 Gateway,可将每个知识库作为 Model Context Protocol(MCP)工具公开;一个用于承载推理智能体的 Runtime;以及 AgenticRetrieveStream,它会在内部重新排序,并返回经过综合且带引用的答案。智能体检索仅适用于 Managed Knowledge Base。
- 现在,可观测性和评估已经成为可以配置的内容,而不是事后再附加的功能。该解决方案随附两个 Amazon CloudWatch 控制面板,涵盖七层遥测数据,并且支持两种评估方式:按需评估和持续评估,全部来自同一次部署。
本文将构建这一系统:一个可在两个知识库之间进行路由的代理,通过 Gateway 检索并返回有依据且带引用的答案,同时对其每一层行为进行检测;整个系统作为一个使用 Python 编写的单一 AWS CDK 应用提供。只需一条命令即可部署全部内容,CDK 会推导部署顺序。
如果你读过2024 年的文章,那么从 Amazon S3 存储桶到知识库的路径会让你感到熟悉,而之后的一切都是新的:向量存储已被移除,检索变为代理式检索,并且该应用所配置的内容中,约有一半用于告知你代理执行了什么。如果你没读过,本文也可以独立阅读。
涉及的服务,以及一个问题在这些服务之间经过的路径如下:代理决定是否进行检索以及要查询哪个知识库,Gateway 将每个知识库暴露为代理可以调用的工具,Managed Knowledge Bases 负责搜索和引用,而这一循环会根据问题的需要重复多次。代理执行过程中的所有操作都会记录到 Amazon CloudWatch 中。
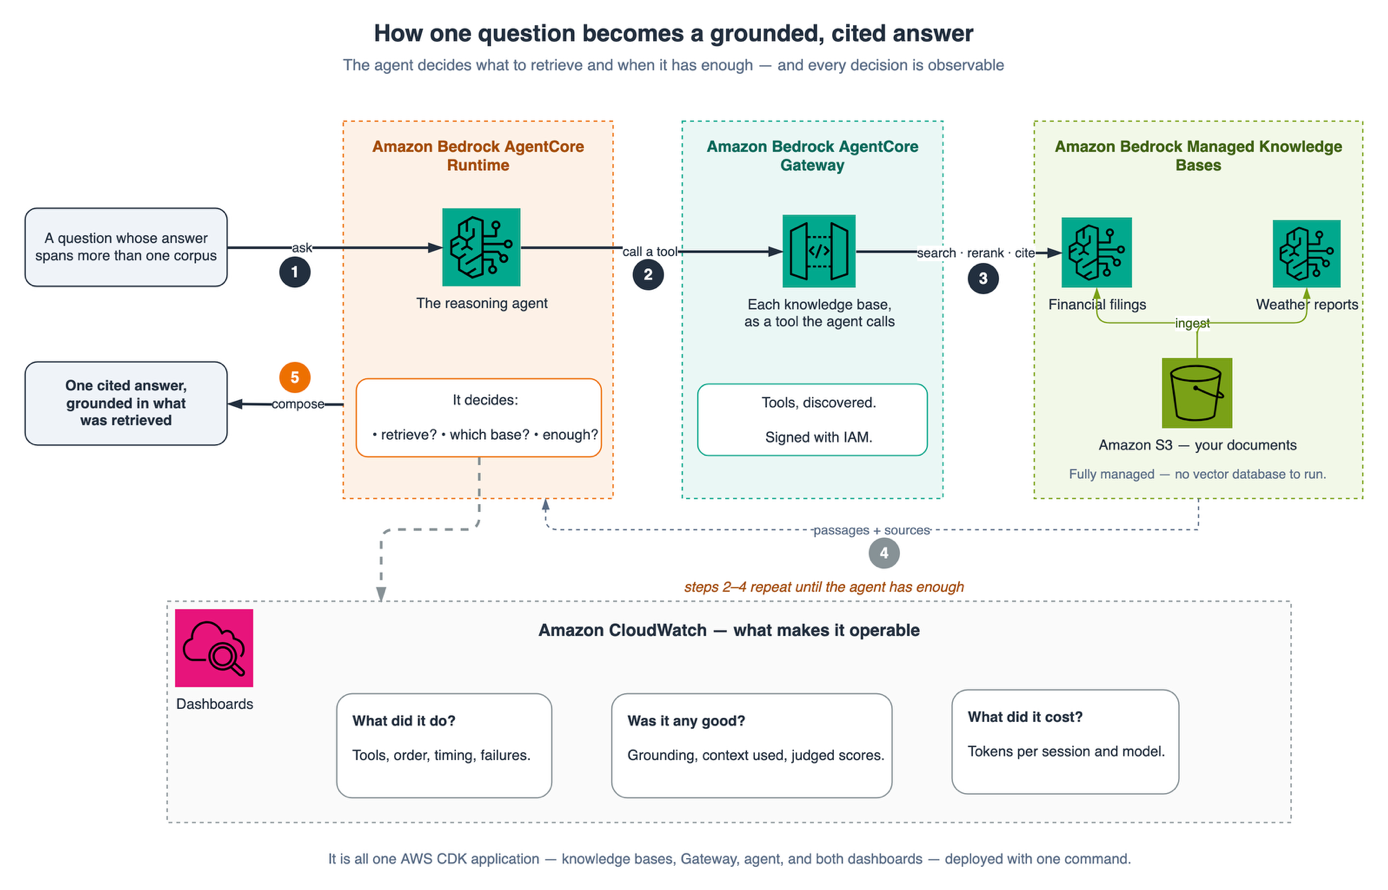
图 1:涉及的服务,以及单个问题在其中经过的路径
背景
在开始演练之前,了解以下三点会有所帮助:什么使检索成为代理式检索,为什么 Managed Knowledge Base 是实现这一目标的正确基础,以及为什么可观测性和评估应当从设计之初就纳入,而不是事后再附加。
从 RAG 到企业级代理式检索
经典的检索增强生成(RAG)执行一次检索和一次生成。企业级代理式检索将推理代理置于流程之中:它决定是否检索以及检索什么,可以多次检索以进行细化,选择相关的知识库(语义路由),然后才生成带有依据和引用的答案。借助 Managed Knowledge Base,这些功能成为服务的一等能力;AgenticRetrieveStream API 执行多轮规划、执行检索并返回带引用的答案,而不是让你在原始向量搜索之上自行构建和维护编排层。这样能够在复杂问题上生成更好的答案,但也会产生更复杂的运营系统,这正是从一开始就内置可观测性和评估功能的原因。
Managed Knowledge Bases 与自行构建的知识库对比
Amazon Bedrock 现在提供Managed Knowledge Base(类型:MANAGED):Amazon Bedrock 会为你管理摄取、存储、索引和检索,默认还包括使用服务管理的模型进行嵌入和重排,因此无需配置、扩展或修补向量数据库。这不同于Customer-managed(DIY)知识库,在后者中,你需要自行选择并运营向量存储(例如 Amazon OpenSearch Serverless)。
对于本解决方案而言,最重要的是以下两点差异:
| 功能 | Amazon Bedrock managed | Customer-managed (DIY) |
| 代理式检索(AgenticRetrieveStream) |  支持 |
 不支持 |
| AgentCore Gateway 集成 | 支持 |
不支持 |
| 数据存储 | 由 Amazon Bedrock 完全托管并自动扩展 | 由你配置、扩展和维护 |
| 嵌入 + 重排 | 内置托管模型,无额外费用 | 由您进行配置 |
| 需要管理的基础设施 | 无 | 向量数据库及更多 |
由于代理式检索和 AgentCore Gateway 连接器仅在托管知识库上可用,因此它是企业级代理式检索的自然基础。这也意味着 Amazon Bedrock 会为您管理存储和索引,因此在此设计中无需预置 OpenSearch Serverless 集合或 OCU 容量。当您希望选择并运营自己的向量存储时,客户托管选项仍然是正确的选择,例如复用现有的 OpenSearch Serverless 集合,或满足特定的数据驻留、调优或合规要求。对于企业级代理式检索而言,托管知识库正是实现该能力的关键。
为什么需要可观测性和评估
一个返回答案的代理式系统还不足以用于生产环境。您需要了解它的运行状况(延迟、调用量、令牌使用量)、检索和答案的质量,并且需要持续获取这些信号。此解决方案提供两个 CloudWatch 控制面板,涵盖七层遥测数据,此外还提供两种评估形式(按需评估和持续评估),全部由同一个 CDK 应用进行预置。基础、引用和评估层还有助于实现负责任的使用。带有引用的答案可以追溯到其来源段落,因此响应始终可审计;而忠实度和正确性评分则能帮助您发现答案偏离来源的情况,而不是等到问题在生产环境中暴露后才发现。
为什么在这一特定解决方案中使用 CDK
任何基础设施即代码工具都可以创建这些资源。CDK 在这里发挥作用,有一个与该架构直接相关的原因:四个堆栈之间存在密集的交叉引用。Gateway 需要两个知识库 ID。代理需要 Gateway 的 URL 和 ARN。控制面板需要知识库 ID、Gateway ARN,以及代理运行时 ID,共有七个值跨越堆栈边界,每个值都是某项指标的维度或某个连接器的目标。
如果使用原始模板编写,这就意味着需要一组堆栈导出值和跨堆栈查找,并手动确保它们保持一致;还需要一个按正确顺序部署并逐层传递输出的脚本,而任何名称发生变化都会导致二者立即出现偏差。在 CDK 中,您只需传递构造,而导出值和依赖边会从这一传递操作中自动派生。2024 年的解决方案包含三个堆栈,依赖链基本是线性的。当堆栈增加到四个、且有七个值在它们之间传递时,差异就不再只是风格上的区别。
解决方案概览
下面介绍单个问题如何端到端地流经整个系统。值得放慢速度仔细查看,因为本文接下来会从左到右逐步讲解。
下图追踪了端到端的代理式检索工作流。用户的问题进入 AgentCore Runtime 上的代理,代理将其路由到 AgentCore Gateway,再由 Gateway 路由到两个 AgenticRetrieveStream 工具之一,每个工具对应一个托管知识库,分别用于金融和天气数据;这些数据均从 Amazon S3 摄取。所选工具返回一个基于依据、带有引用的答案,每一步都会流式传输到 Amazon CloudWatch 和 AWS X-Ray。编号徽章对应下面的逐步说明。
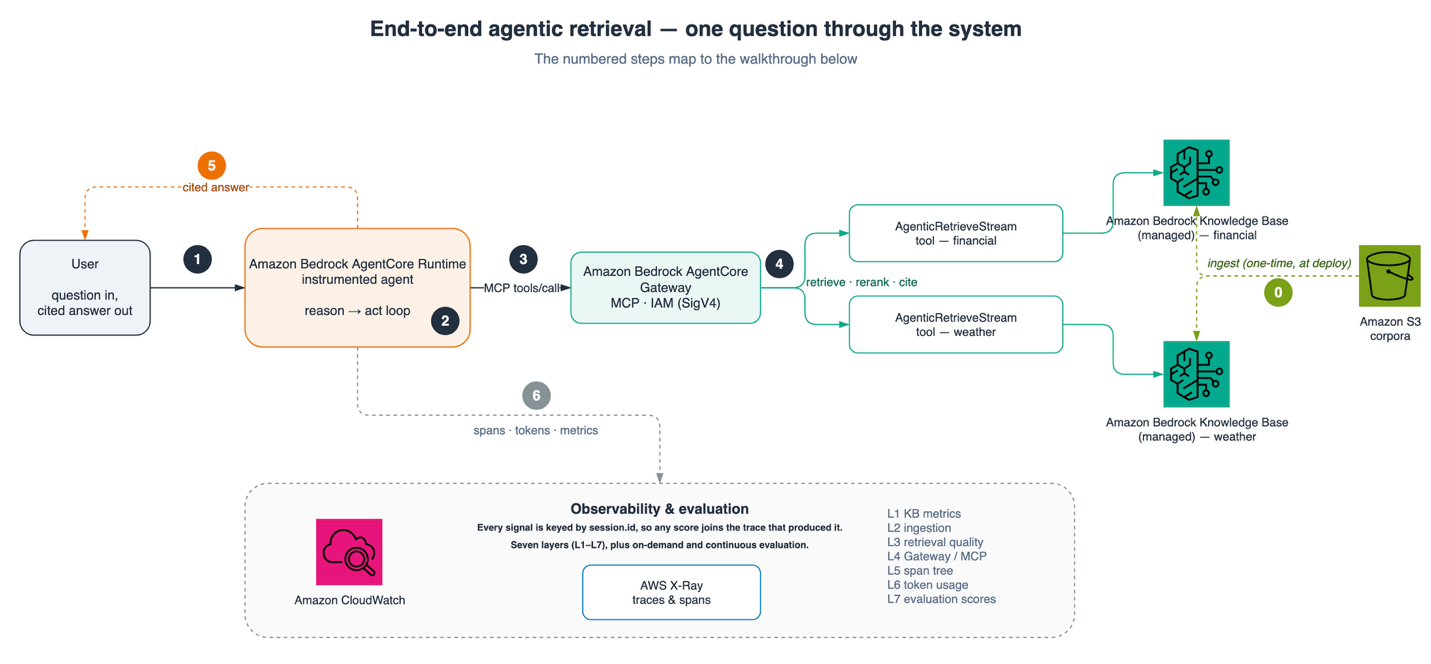
图 2:单个问题的端到端代理式检索工作流
图中的编号步骤对应以下工作流。
步骤 0——部署时一次性执行。 在提出任何问题之前,Amazon S3 中的每个语料库都会被摄取到各自的托管知识库中:Amazon Bedrock 会自动解析、分块、生成嵌入并建立索引。这只会在堆栈部署时执行一次,不属于每个问题的处理路径,因此绘制为虚线箭头并标记为步骤 0。之后,每个问题都会依次经过步骤 1–6:
- 用户向托管在 Amazon Bedrock AgentCore Runtime 上的代理发送问题。Runtime 会使用 OpenTelemetry (OTEL) span 自动记录整个推理与行动循环,因此系统从第一次调用开始就是可观测的。
- 代理的推理模型会在各个知识库之间进行规划和路由。 由于每个知识库都作为独立的检索工具公开,代理会选择主题与问题匹配的工具,例如金融或天气,而不是搜索一个混合索引。
- 选定的工具调用由 AgentCore Gateway 通过 MCP 代理处理,由代理的 IAM 任务角色授权并使用 SigV4 签名,然后调用托管知识库上的该知识库 AgenticRetrieveStream API。
- AgenticRetrieveStream 负责知识库内部的工作:它会将问题分解为子查询,从 Amazon Bedrock 管理的数据存储中进行迭代检索(数据由 Amazon S3 中的语料库摄取而来),并综合生成有依据且带引用的答案,再通过 Gateway 流式返回。
- 代理会检查返回的上下文是否足够。 如果不够,它会再次进行路由和检索,然后再编写最终答案。如果足够,它就会将带引用的答案返回给用户。
- 在整个过程中,Runtime 会将 spans、令牌计数和指标发送到 Amazon CloudWatch 和 AWS X-Ray,填充七个可观测性层,并为按需评估和持续评估分数提供数据。
在内部,该工作流是一个 CDK 应用 app.py,其中声明了四个堆栈。你无需选择顺序,CDK 会根据你传入的构造引用自动推导顺序:
kb_stack = KnowledgeBasesStack(app, f"{project}-kb", env=env)

gateway_stack = AgenticGatewayStack(
    app, f"{project}-gateway", env=env,
    financial_kb=kb_stack.financial_kb,  # ← the reference creates the dependency
    weather_kb=kb_stack.weather_kb,
)

agent_stack = AgentRuntimeStack(
    app, f"{project}-agent", env=env,
    gateway=gateway_stack.gateway,
)

DashboardsStack(
    app, f"{project}-dashboards", env=env,
    financial_kb=kb_stack.financial_kb,
    weather_kb=kb_stack.weather_kb,
    gateway=gateway_stack.gateway,
    agent_runtime=agent_stack.agent_runtime,
)
这就是完整的连接方式。这四个构造函数调用取代了导出/导入管理和部署脚本。
| # | 堆栈 | 创建内容 | 备注 |
| 1 | -kb | S3 存储桶、语料库上传、两个 Type: MANAGED KB、数据源、IAM、摄取 | KB 达到 ACTIVE 状态,语料库已摄取 |
| 2 | -gateway | Gateway(AWS_IAM / MCP)、每个 KB 的 AgenticRetrieveStream 目标 | 无需 Cognito |
| 3 | -agent | ECR、CodeBuild、Runtime 上经过插桩的 Strands 代理、服务提供的日志/追踪、在线评估 | 约 8–10 分钟(镜像构建) |
| 4 | -dashboards | agentic-observability + kb-observability 控制面板 | 在产生流量之前为空 |
代理运行一个推理与行动循环:它进行思考(一次大型语言模型(LLM)调用),决定调用哪个 KB 工具,读取通过 Gateway 返回的内容,并且通常会再次进行检索,然后编写最终的带引用答案。每一步都会由 Runtime 自动插桩,因此七个可观测性层会根据真实流量逐步填充。
七个层级。 L1 KB 原生指标、L2 摄取、L3 代理检索质量、L4 Gateway/MCP 指标、L5 OTEL span 树、L6 令牌使用量,以及 L7 评估分数。第 1、4 和 5 层会自动生成。第 3、6 和 7 层由驱动笔记本发布为自定义指标。
所有可调参数都位于一个文件 config.py 中:
| 设置 | 含义 | 默认值 |
EnvSettings.PROJECT_NAME |
每个堆栈和资源的名称前缀 | bmkb-obs-cdk |
EnvSettings.ACCOUNT_REGION |
要部署到的 AWS 区域 | us-west-2(或您的配置文件所在区域) |
KbConfig.EMBEDDING_MODEL_TYPE |
MANAGED(捆绑提供)或 CUSTOM(使用您自己的 ARN) |
MANAGED |
AgentConfig.MODEL_ID |
智能体的推理模型,即第 6 层开销 | Claude Haiku 4.5 |
EvalConfig.SAMPLING_PERCENTAGE |
在线评估采样率,请参阅免责声明 | 100 |
更改 PROJECT_NAME 会为整个解决方案生成一个名称独立的副本,因此两个部署可以共存于同一个账户中。驱动笔记本读取相同的常量,因此会自动跟随重命名,无需手动同步任何堆栈名称。
描述数据集
该解决方案附带两个小型语料库,存放在仓库的 data/ 目录下:
- 金融 — 一份合成的 Octank Financial 10-K(octank_financial_10K.pdf,约 198 KB)。
- 天气 — 一份真实、公开可用的美国国会研究服务部关于龙卷风的报告(IF12695,tornadoes_report.pdf,约 560 KB)。
 关于数据: 金融语料库是合成的。Octank 是一家虚构公司,该 10-K 是模型生成的示例数据(采用 CC0 许可)。它不 是真实的财务数据。天气语料库是一份真实的、属于公有领域的美国政府作品,也是美国国会研究服务部的报告,可在 sgp.fas.org/crs/misc/IF12695.pdf 公开获取(美国政府作品不受版权保护)。如需使用您自己的数据,请将文件放入 data/ 下,并调整
config.py 中的前缀,无需进行其他更改。
这两个语料库有意设置为彼此不同,因此智能体必须将每个问题路由到正确的知识库,这就是语义路由的核心。由于这些是托管式知识库,我们无需配置分块、嵌入或索引:在摄取时,Amazon Bedrock 会解析每个 PDF,进行分块,使用其托管模型生成嵌入,并自动建立索引。
我们使用两个独立的知识库,并通过 Gateway 将每个知识库分别作为独立的检索工具提供,而不是使用一个同时包含两个语料库的知识库;这一选择是经过刻意设计的。为智能体提供两个命名工具,可以让路由成为一个明确可观察的推理行为:跨度树会显示对于给定问题它选择了哪个工具,而第 3 层中的检索质量指标也会按知识库保持分离,因此金融和天气的精确率不会模糊成一个数字。一个覆盖两个语料库的单一工具会抹平这种区别,路由决策会转移到单个索引的排序过程内部而不可见,并且所有质量信号都会成为两个无关领域的平均值。保持语料库及其工具彼此分离,正是让智能体行为清晰可读的原因,而这就是本练习的全部目的。
在 CDK 中,将语料库放入 S3 的方式是使用 BucketDeployment:
s3deploy.BucketDeployment(
    self, "FinancialCorpus",
    sources=[s3deploy.Source.asset(str(ROOT / "data" / "financial"))],
    destination_bucket=self.source_bucket,
    destination_key_prefix=KbConfig.FINANCIAL_PREFIX,
)
之所以值得了解 BucketDeployment,恰恰是因为另一种方式非常诱人:没有它,触发摄取的自定义资源往往会逐渐加入上传步骤,这样一来,一个资源就承担了两个无关的任务。而在这里,它只需要负责摄取。
托管式摄取会自动扫描、分块、生成嵌入并为每份文档建立索引:每个知识库索引一份文档,失败数为零。
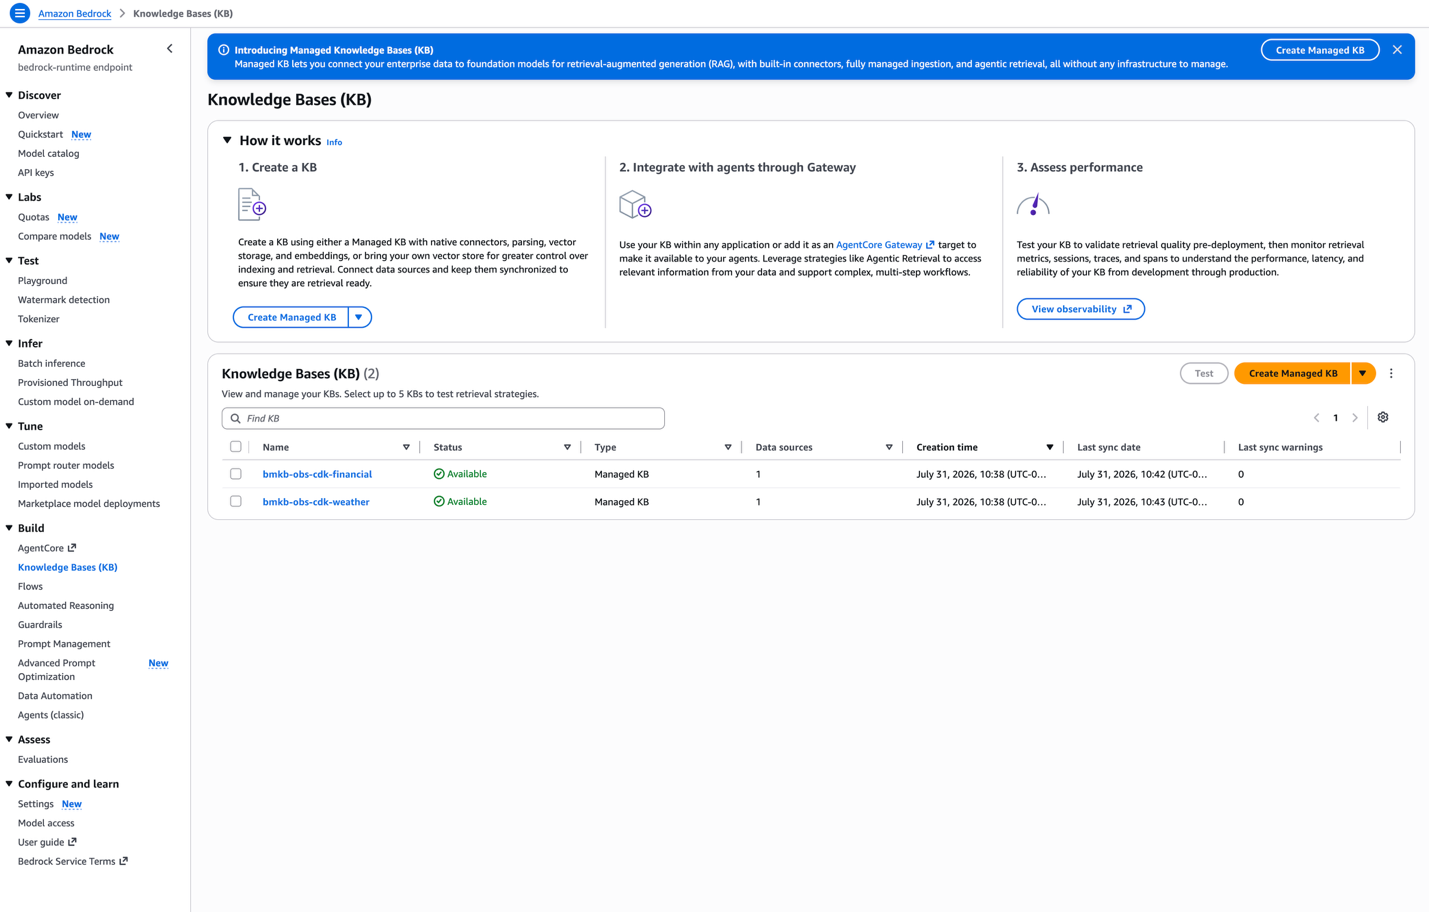
图 3:托管式摄取结果,每个知识库索引一份文档且失败数为零
部署解决方案
本节将介绍如何使用一条命令部署整个解决方案。满足先决条件后,cdk deploy --all 会按照 CDK 推导出的依赖顺序配置全部四个堆栈,并自动传递所有跨堆栈值。
先决条件
- 一个拥有 Amazon Bedrock、AgentCore(Runtime + Gateway)、AWS Identity and Access Management (IAM)、CloudWatch、AWS X-Ray、Amazon Elastic Container Registry (Amazon ECR)、AWS CodeBuild、Amazon S3、AWS Lambda 和 AWS CloudFormation 权限的 AWS 账户。
- 账户中可用的代理模型(默认
us.anthropic.claude-haiku-4-5-20251001-v1:0)。 - 已启用 CloudWatch Transaction Search,因此 OTEL spans 会落入 aws/spans,供第 5–7 层使用。
- Node.js 18+ 和 CDK CLI(
npm install -g aws-cdk),以及 Python 3.13+。 - 已为 CDK 完成引导的账户和区域(cdk bootstrap),每个账户/区域执行一次。
- 无需本地 Docker,代理镜像由 CodeBuild 构建(ARM64)。
一条命令
要部署此解决方案,请克隆存储库、创建虚拟环境、安装依赖项,然后运行 cdk deploy --all。请在终端中运行以下命令:
git clone https://github.com/aws-samples/amazon-bedrock-samples.git
cd rag/managed-knowledge-bases/07-IaaC/managed-kb-observability-cdk/
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cdk bootstrap  # once per account/region
cdk deploy --all
前两条命令会克隆示例并进入项目目录。接下来的两条命令会创建并激活 Python 虚拟环境,然后安装 CDK 应用的依赖项。cdk bootstrap 会为 CDK 准备账户和区域(每个账户/区域只需执行一次),而 cdk deploy --all 会配置全部四个堆栈。
账户和区域取自你的 AWS 配置文件(CDK_DEFAULT_ACCOUNT / CDK_DEFAULT_REGION),因此无需修改应用即可部署。
区域可用性:托管知识库、代理式检索(AgenticRetrieveStream)以及 Amazon Bedrock AgentCore(Runtime 和 Gateway)并非在所有 AWS 区域都可用。部署前,请确认这些服务都在你的目标区域提供,并据此在 config.py 中设置 ACCOUNT_REGION。默认值为 us-west-2。有关当前可用性,请参阅 Amazon Bedrock 和 Amazon Bedrock AgentCore 文档,以及 AWS Regional Services List。
此版本没有部署脚本,而这正是其设计目的:cdk deploy --all 会遍历它从 app.py 派生出的依赖关系图,按顺序部署四个堆栈,并自动传递所有跨堆栈值。终端会报告每个堆栈的完成情况:bmkb-obs-cdk-kb [1/4](默认 PROJECT_NAME),然后是 gateway [2/4],接着是 agent [3/4],最后是 dashboards [4/4];该顺序并非显式声明,而是由堆栈之间的构造引用自然派生出来的。因此,添加一个使用现有输出的第五个堆栈后,部署顺序也会自动重新排列。
Stack -agent 会使用 CodeBuild 构建代理容器,因此该阶段大约需要 8–10 分钟。其他三个堆栈很快即可完成。每个堆栈完成时都会输出其结果;知识库 ID、Gateway URL、运行时 ARN 以及两个控制面板 URL 都可以在这里获取。部署完成后,四个堆栈全部完成。下面的屏幕截图展示了 cdk deploy --all 成功完成后 AWS CloudFormation 控制台中的状态。
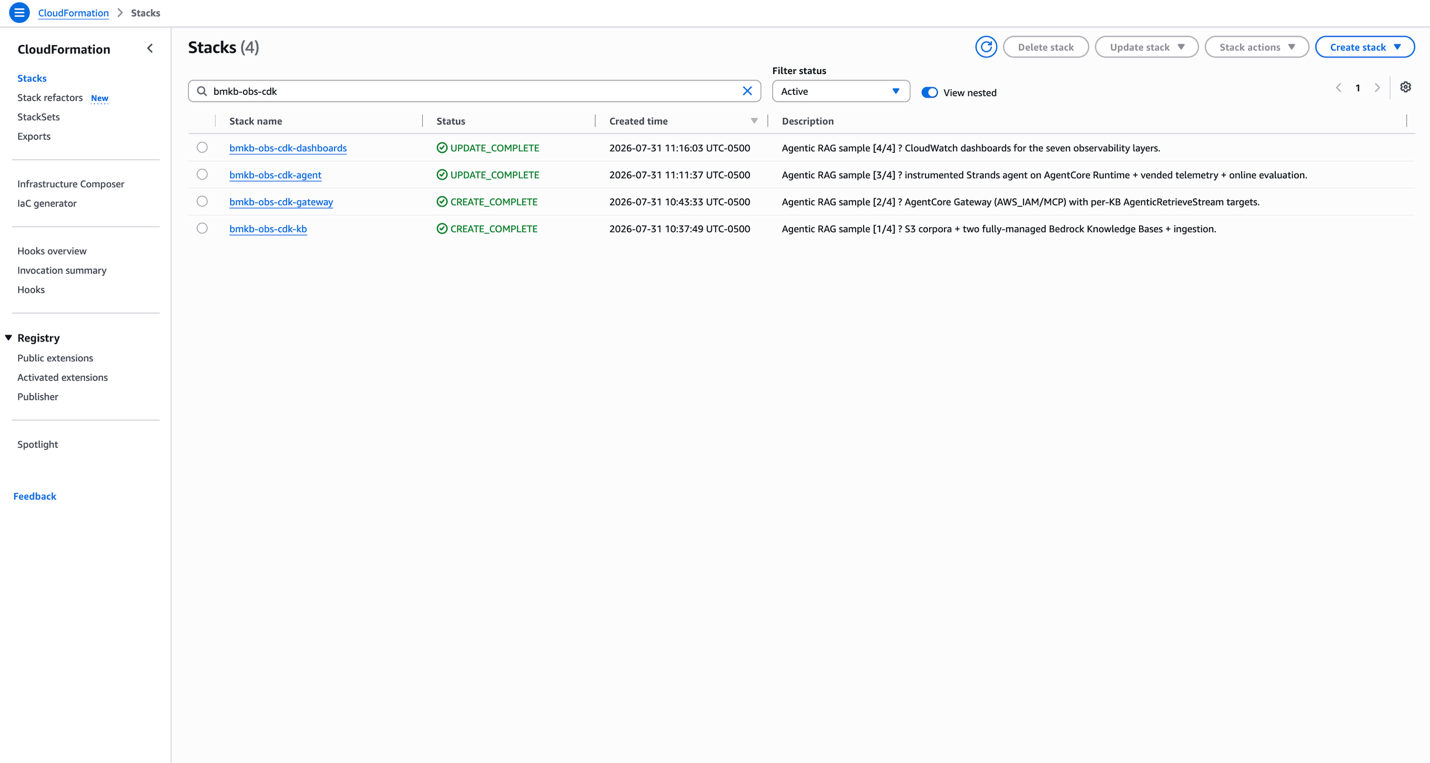
图 4:成功部署后 AWS CloudFormation 控制台的状态,四个堆栈均为 CREATE_COMPLETE
在控制台中,四个堆栈 kb、gateway、agent 和 dashboards 均报告 CREATE_COMPLETE,并且每个堆栈的描述中都显示了其在派生依赖顺序中的 [n/4] 位置。
关于长时间运行资源的说明
此解决方案中有两项操作所需时间远超 AWS Lambda 函数允许的 15 分钟上限,无法采用简单的轮询方式:知识库摄取同步和 CodeBuild 镜像构建。AWS CDK Provider 框架通过 on_event / is_complete 拆分来处理这一问题:一个处理程序启动任务,另一个处理程序持续轮询,直到任务报告完成。
cr.Provider(
    self, "IngestSyncProvider",
    on_event_handler=on_event,        # StartIngestionJob, return the job id
    is_complete_handler=is_complete,  # GetIngestionJob, report IsComplete
    query_interval=Duration.seconds(30),
    total_timeout=Duration.minutes(30),
)
没有任何阻塞操作,向 CloudFormation 回传响应的协议由框架负责,而不是手动写入每个处理程序;30 分钟的时间预算是一个属性,而不是需要费心绕过的限制。
启动并测试
打开 notebooks/01-drive-and-observe.ipynb,按从上到下的顺序运行(先运行 pip install -r requirements-notebook.txt)。它会读取堆栈输出,然后向已部署的智能体发送特定主题的提示,每个 KB 使用一个会话,让你可以在同一处查看回答和语义路由:财务问题根据 Octank 10-K 回答,天气问题根据龙卷风报告回答,每类问题都会自动路由到对应的 AgenticRetrieveStream 工具。
该笔记本从堆栈输出中获取所有信息,因此无需手动粘贴任何内容:
# Stack names are derived from the same PROJECT_NAME the CDK app uses, so renaming the
# project in config.py cannot leave this notebook pointing at stale stacks.
from config import EnvSettings

PROJECT = EnvSettings.PROJECT_NAME
STACKS = {suffix: f'{PROJECT}-{suffix}'
          for suffix in ('kb', 'gateway', 'agent', 'dashboards')}

def outputs(stack_name):
    s = cfn.describe_stacks(StackName=stack_name)['Stacks'][0]
    return {o['OutputKey']: o['OutputValue'] for o in s.get('Outputs', [])}
该笔记本导入的 config.py 与应用导入的相同,因此两者对堆栈名称的认定永远不会出现分歧。
驱动程序通过已部署的智能体发送针对各 KB 的提示。财务问题路由到财务 KB,天气问题路由到天气 KB,每个问题都会得到有依据、带引用的回答。
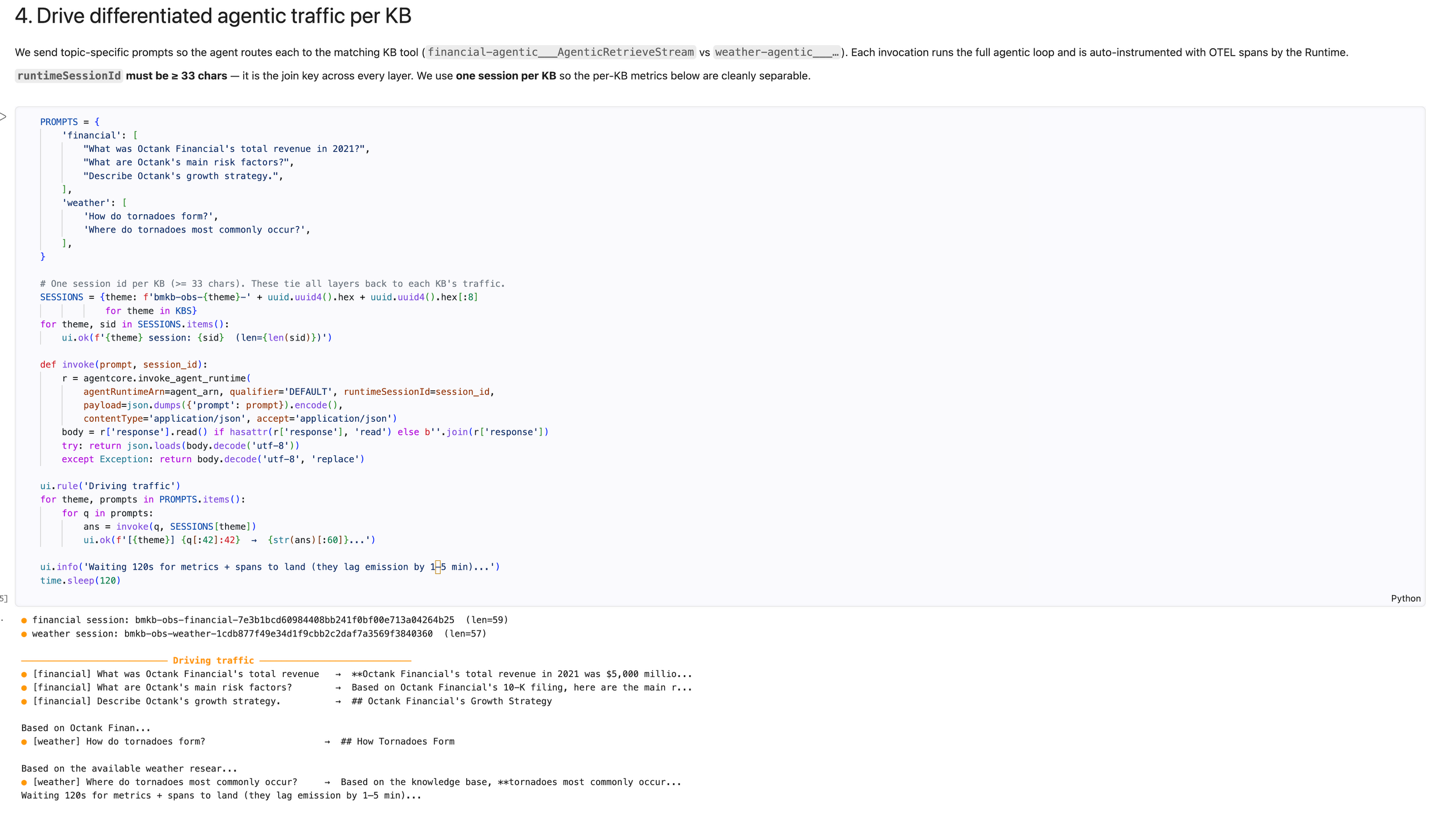
图 5:针对各 KB 的提示被路由到相应的知识库,每个知识库都返回有依据、带引用的回答
该笔记本还会根据智能体实际检索和引用的内容,计算无需参考答案的第 3 层检索质量指标,无需真实标准答案,也无需额外的评判模型,并将这些指标发布到 CloudWatch。
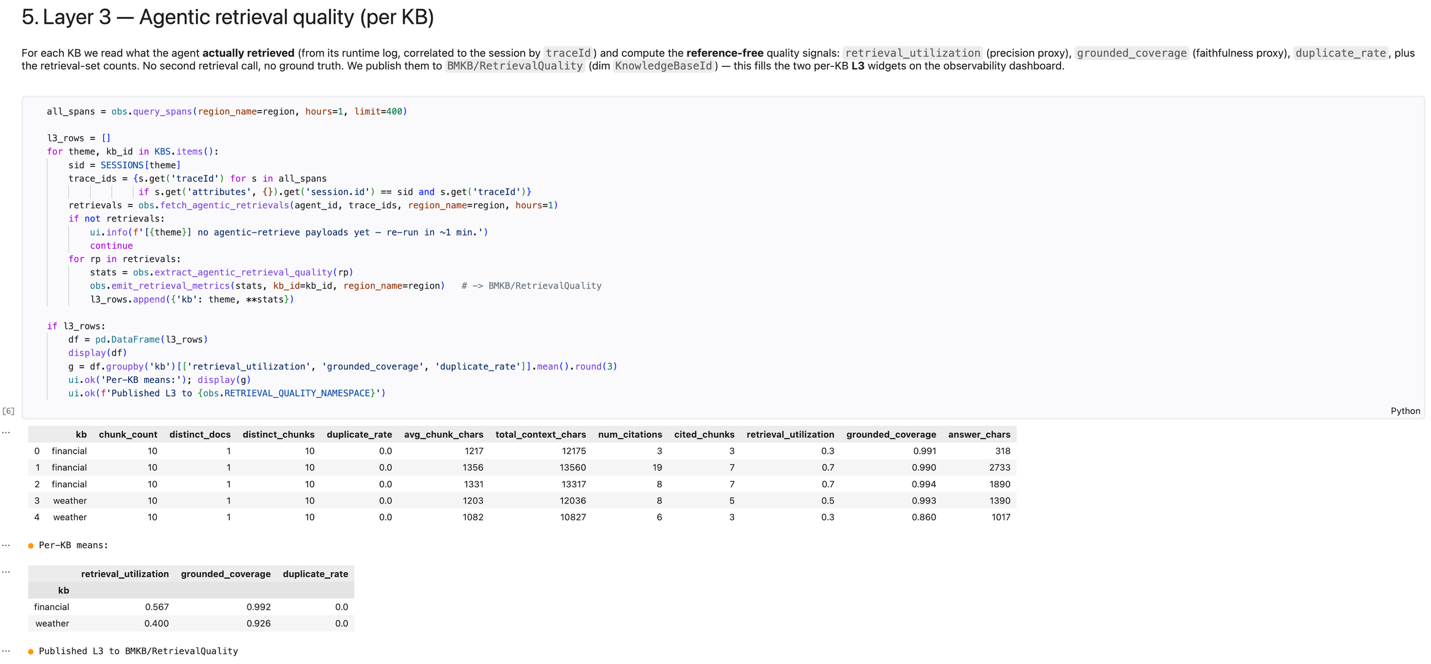
图 6:各知识库无需参考答案的第 3 层检索质量指标
观测:七层仪表板
这两个仪表板让七个层面的情况变得清晰可见。堆栈会创建这两个仪表板,产生的流量则会为它们填充数据。以下截图展示了这两个仪表板在 CloudWatch 控制台中的样貌。
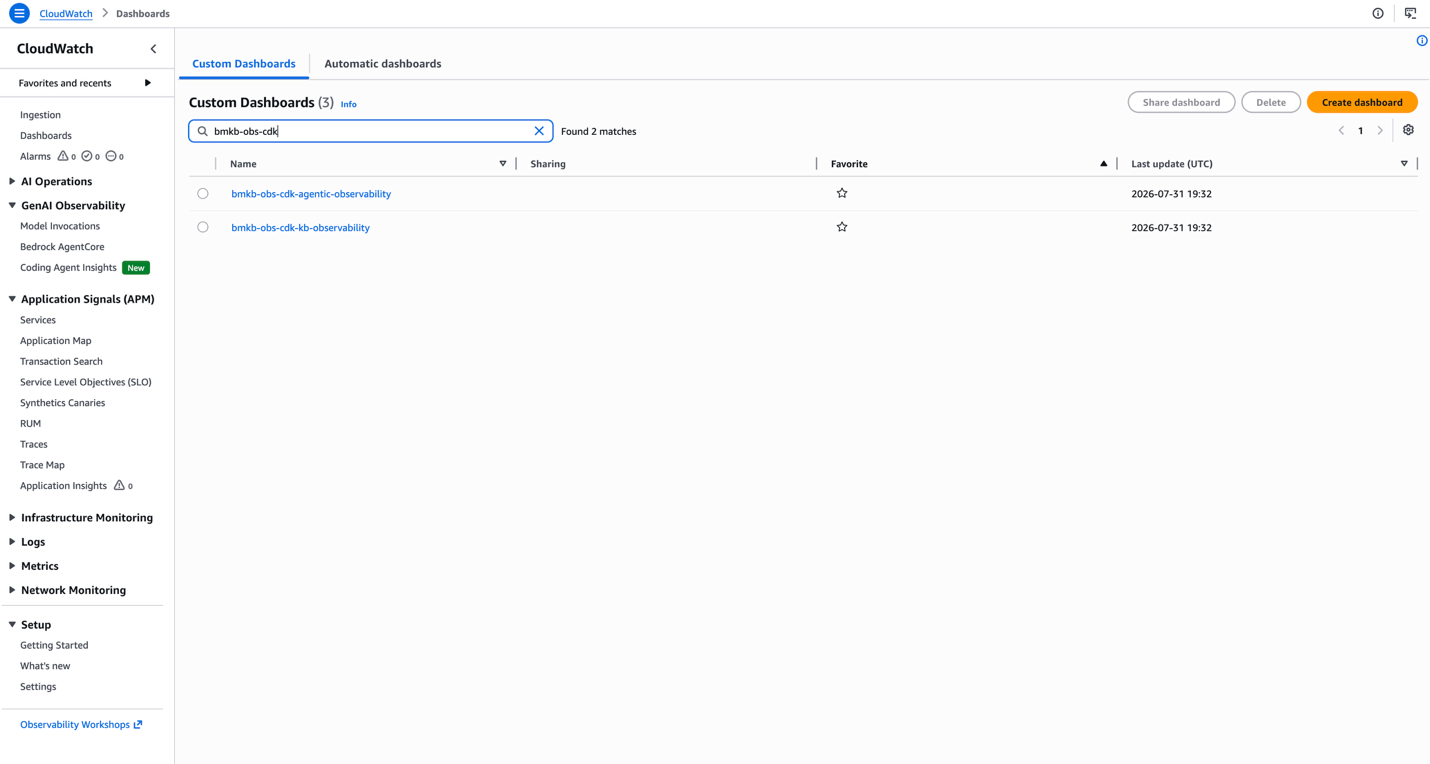
图 7:CloudWatch 控制台中的两个仪表板,分别提供端到端智能体可观测性和各 KB 的可观测性
两个仪表板都会显示在 CloudWatch 控制台中:一个用于端到端智能体可观测性,另一个用于各 KB 的可观测性(BMKB,Bedrock 托管知识库)。本节其余部分将逐层介绍各层展示的内容。
在此版本中,仪表板使用类型化对象构建,而不是 JSON 字符串。指标是 Metric,组件是 GraphWidget,而布局则是 Rows 列表:
cw.GraphWidget(
    title="L4 — Gateway metrics (MCP)",
    width=12, height=6, period=PERIOD, statistic="Sum",
    left=[
        self._gateway_metric("Invocations", gateway_arn, "tools/call Invocations"),
        self._gateway_metric("SystemErrors", gateway_arn, "SystemErrors"),
        self._gateway_metric("UserErrors", gateway_arn, "UserErrors"),
        self._gateway_metric("Throttles", gateway_arn, "Throttles"),
    ],
)实际好处并不是代码行数更少,dashboards_stack.py 长达 400 行,比等效的 DashboardBody JSON 还多。真正的好处是,属性拼写错误或无效的组件组合会在你的笔记本电脑上执行 cdk synth 时于约一秒内报错。同样的错误如果出现在 DashboardBody 字符串中,部署仍会成功,但在 AWS 管理控制台中会呈现为损坏的组件,只有查看时才会发现。
由于 Row 接受任何组件,文档便成了布局的一部分,而不是会逐渐与实际情况脱节的 wiki 页面。每个仪表板都会在图表之间穿插 TextWidgets:
[cw.TextWidget(width=24, height=7, markdown=self._l3_explainer())],
[
    self._quality_widget("L3 · Financial KB — agentic quality (reference-free, 0–1)", fin_id),
    self._quality_widget("L3 · Weather KB — agentic quality (reference-free, 0–1)", wx_id),
],
_l3_explainer() 返回一个 markdown 表格,定义各个比率及其解读方式,因此,解释 grounded_coverage 的组件会与绘制该指标的组件在同一次提交中交付,而首次打开仪表板的读者也无需猜测什么是无需参考答案的指标。
仪表板 A——代理式可观测性(端到端)。 看板首先解释每一层如何统计不同的对象(对于 N 个查询,你将看到约 N 次代理调用、约 2N 次检索、约 3N 次 LLM 调用,以及约 5N 次 Gateway MCP 操作,从而让代理式循环变得可见),然后展示 KB 指标(L1)、Gateway 指标和延迟(L4)、令牌使用量(L6),以及由于代理使用 AgenticRetrieveStream(该接口返回综合且带引用的答案,而不是逐块得分),展示无参考的第 3 层质量信号;这些信号在行内定义,并按 KB 绘制。
在仪表板 A 中,第 3 层的无参考质量信号按知识库绘制。首先是金融 KB。下图绘制了其 retrieval_utilization、grounded_coverage 和 duplicate_rate。
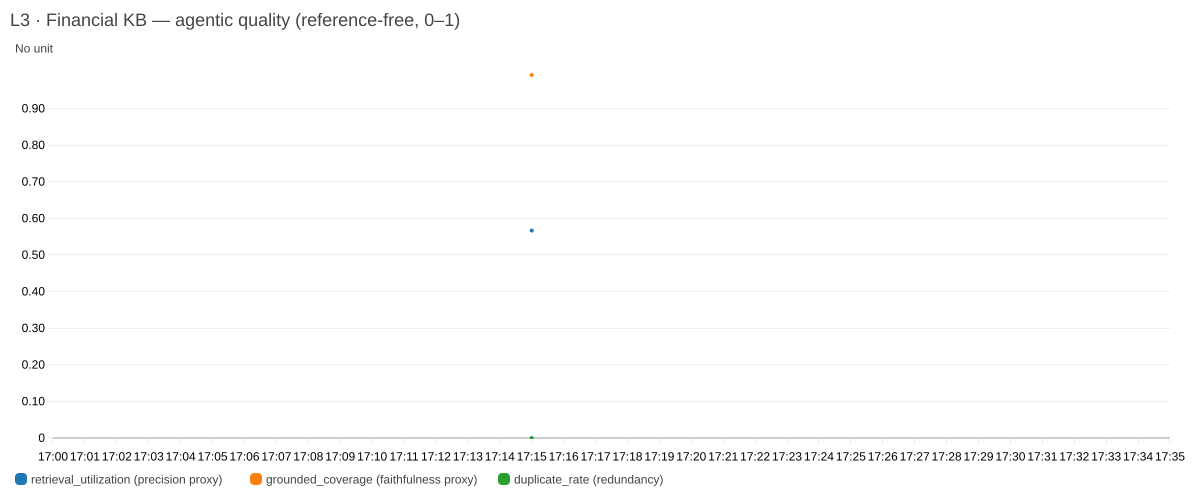
图 8:金融 KB 第 3 层质量,绘制检索利用率、依据覆盖率和重复率
天气 KB 展示相同的三个信号,并分别进行跟踪,因此两个领域不会混合成一个数值。
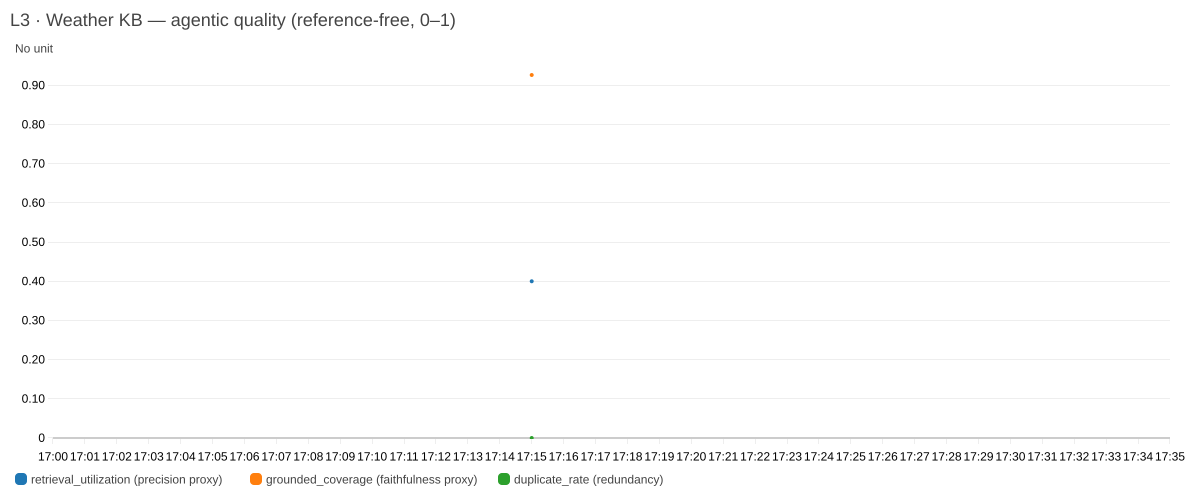
图 9:天气 KB 第 3 层质量,与金融 KB 分开跟踪
两张图分别绘制金融 KB(左)和天气 KB(右)的 retrieval_utilization、grounded_coverage 和 duplicate_rate,因此每个知识库的检索质量都保持可区分,而不会被平均成一个数值。
仪表板 B——按 KB(BMKB)的可观测性。 按 KB 统计、同时也决定开支的运营信号:索引大小(来自 S3 源字节数)、检索量、代理式工具调用次数、会话令牌使用量,以及按模型统计的生成令牌使用量;每项都附有行内说明。
以下截图展示了仪表板 B 的四个指标组件,这些组件在一次运行后填充数据。第一个组件报告每个知识库的索引大小,该数值根据 S3 源字节数得出。
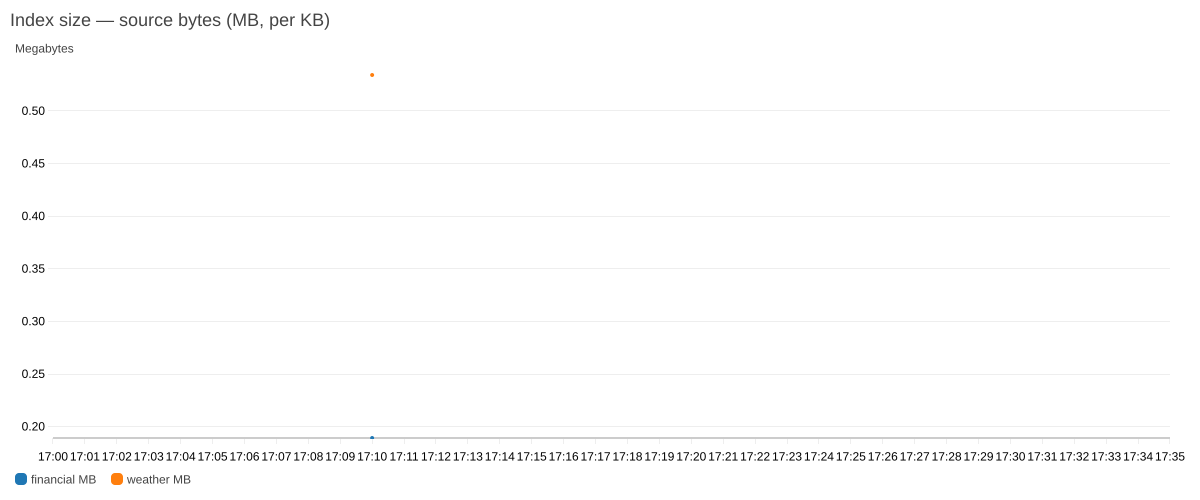
图 10:仪表板 B 中按知识库统计的索引大小,根据 Amazon S3 源字节数得出
第二个组件统计每个知识库的检索调用次数。
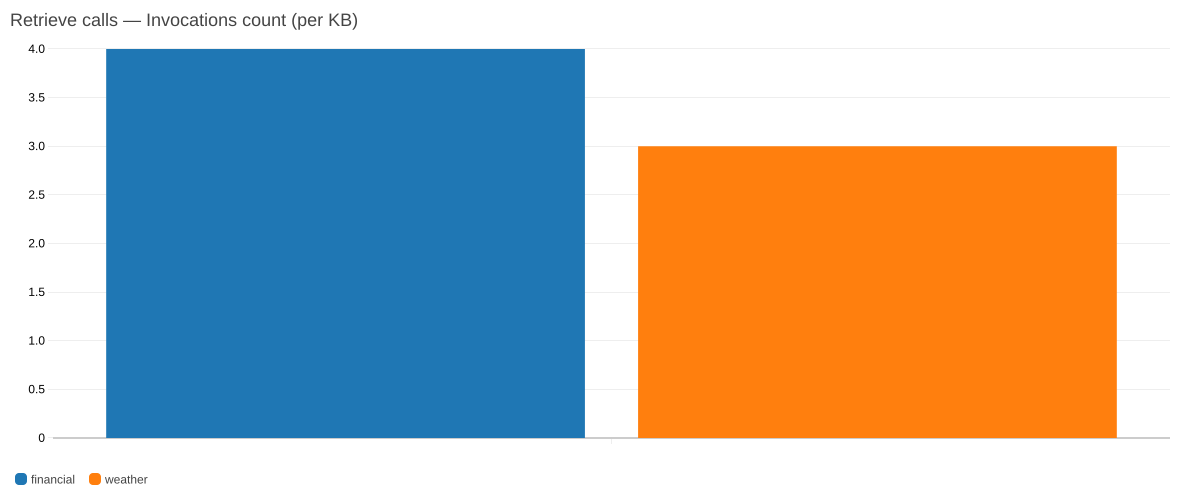
图 11:仪表板 B 中按知识库统计的检索调用次数
第三个组件统计通过 Gateway 进行的代理式工具调用次数。该指标由两个 KB 共享,而不是分别拆分。
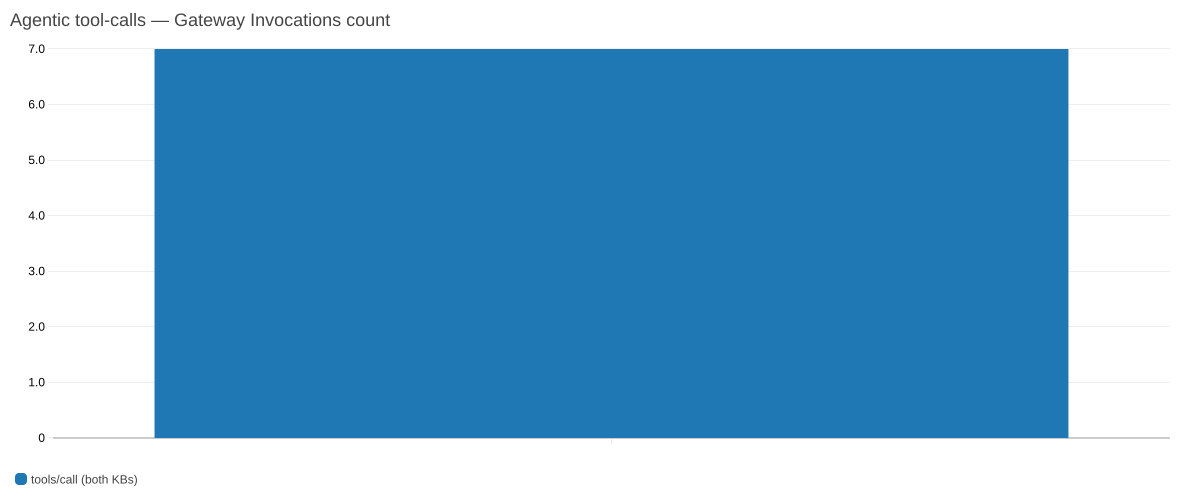
图 12:通过 AgentCore Gateway 进行的代理式工具调用次数,由两个知识库共享
第四个组件报告每个知识库的会话令牌使用量。
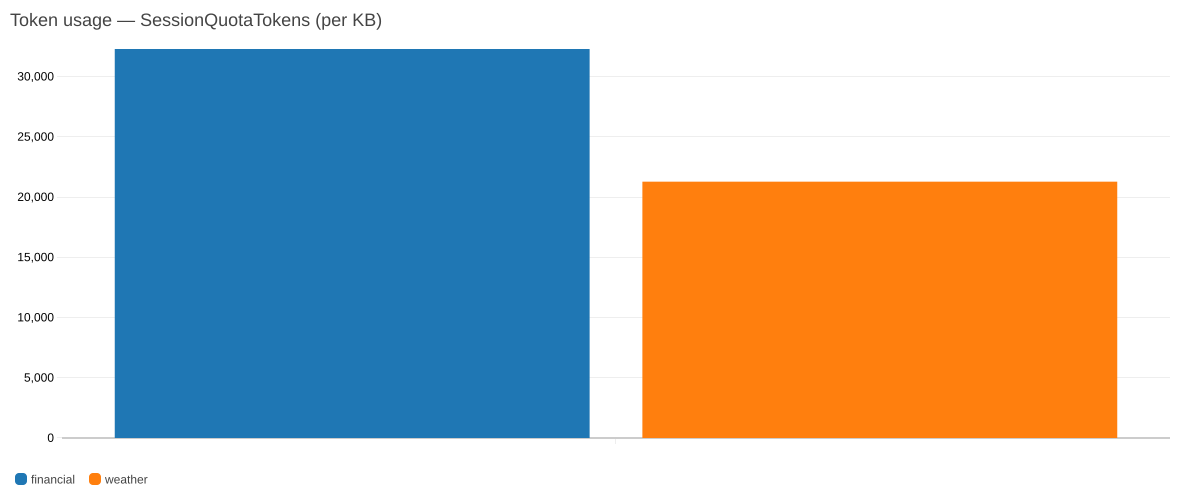
图 13:仪表板 B 中按知识库统计的会话令牌使用量
四个组件展示索引大小(来自 S3 源字节数)、检索调用量、通过 Gateway 进行的代理式工具调用次数,以及会话令牌使用量。除 Gateway 工具调用次数由两个知识库共享外,其余各项均按知识库拆分。
有一个维度细节值得特别指出,因为类型化 API 不会替你捕获这一点:AWS/Bedrock/KnowledgeBases 命名空间要求使用带前缀的 id,即 knowledge-base/<id>;而解决方案自身的 BMKB/* 命名空间使用不带前缀的 id。对 CDK 而言,两者都只是字符串。
# L1 — AWS/Bedrock/KnowledgeBases wants the prefixed form.
dimensions_map={"Operation": "Retrieve", "KnowledgeBaseId": f"knowledge-base/{kb_id}"}

# BMKB/* — our own namespaces use the bare id.
dimensions_map={"KnowledgeBaseId": kb_id}
第 5 层:span 树
第 5 层是 aws/spans 中的原始 OTEL span 树,也是直接展示代理式循环的层。值得仔细阅读,因为其嵌套关系并不直观:一次 LLM 调用会生成三个 span。Strands 的 invoke_agent span 包裹整个轮次,一个内部的 chat span 包裹模型调用,而一个类型为 CLIENT 的 chat <model> span 才是真正的调用,并且这三个 span 都会重复使用相同的 gen_ai.usage.* 令牌属性。
以下截图展示了 aws/spans 中的 span 树,顶部行显示了这三层 span 嵌套关系。
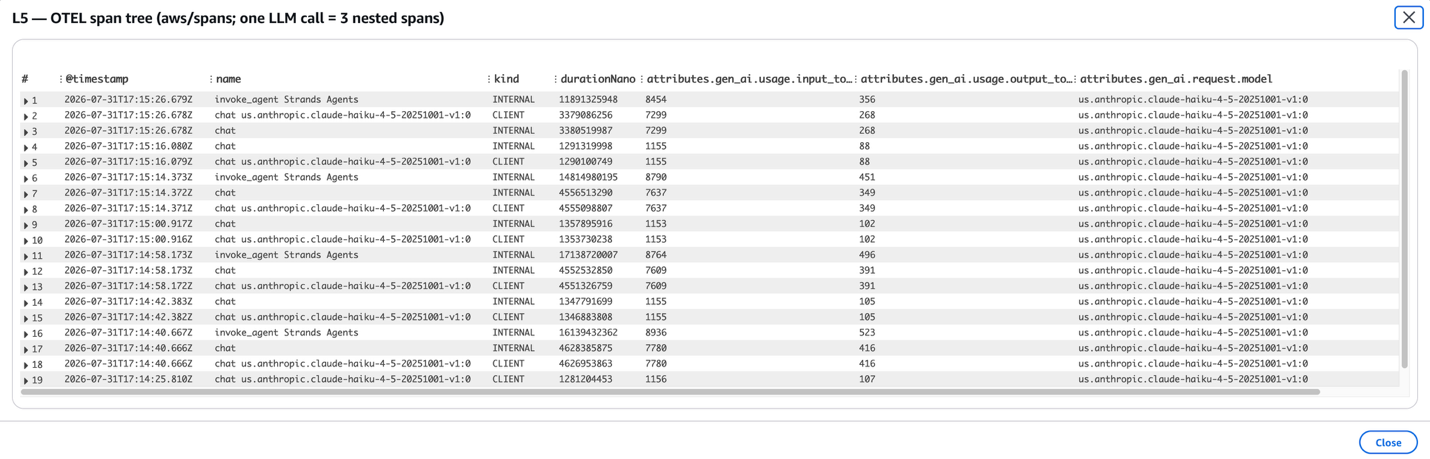
图 14:aws/spans 中的第 5 层 span 树,展示单次 LLM 调用的三层 span 嵌套
阅读前 3 行:首先是一个 invoke_agent Strands Agents 聚合项,然后是一个内部 chat span,接着是一个 CLIENT chat span,它们报告的输入 token 和输出 token 完全相同,分别为 7,299 和 268。这是同一个 LLM 调用出现在树的 3 个层级中,因此聚合时需要格外注意。
这种结构在进行聚合时就很重要。若要使每个 LLM 调用只计数一次,请筛选到 CLIENT 叶节点:
fields attributes.gen_ai.request.model as model,
       attributes.gen_ai.usage.input_tokens as in_tok,
       attributes.gen_ai.usage.output_tokens as out_tok
| filter ispresent(in_tok) and kind = 'CLIENT' and name like /^chat /
| stats sum(in_tok) as input_tokens, sum(out_tok) as output_tokens,
        count(*) as llm_calls by model
如果不使用该筛选条件,同一个查询会报告 3 倍的 token 数和 3 倍的调用次数。
应用此 CLIENT 叶节点筛选条件后,下面的截图显示了按模型划分的生成 token 使用量,其中每个 LLM 调用只计数一次。
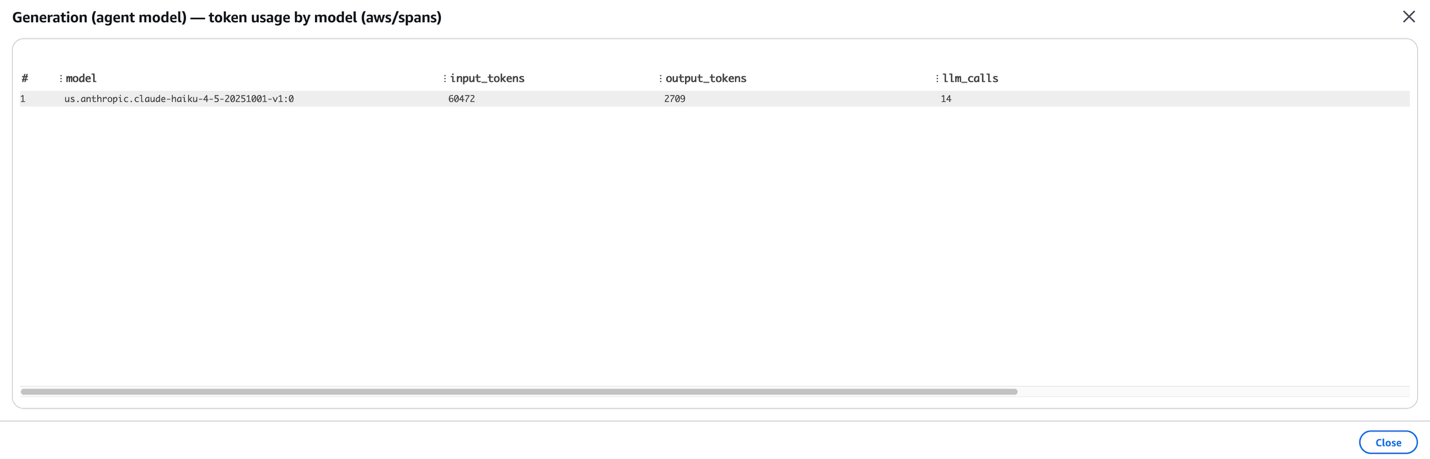
图 15:按模型划分的生成 token 使用量,其中每个 LLM 调用只计数一次
应用筛选条件后,本次运行显示共有 14 次 LLM 调用,总计 60,472 个输入 token 和 2,709 个输出 token。如果不使用该筛选条件,同一个查询会报告 3 倍的调用次数和 3 倍的 token 数。
评估:按需评估与持续评估
质量通过两种方式进行衡量,并且两者都由应用进行配置。
按需评估:驱动程序 notebook 会针对每个会话的 span 调用 AgentCore There is no deploy script in this version, and that is the point: (LLM-as-judge),使用内置评估器 Correctness、Faithfulness、Tool-Selection Accuracy,并将分数发布到 CloudWatch,在 Dashboard A 中作为第 7 层显示。
下面的截图显示了 Dashboard A 中的第 7 层:每个知识库的按需评估分数,以及同一仪表板中的第 5 层 OTEL span 表。
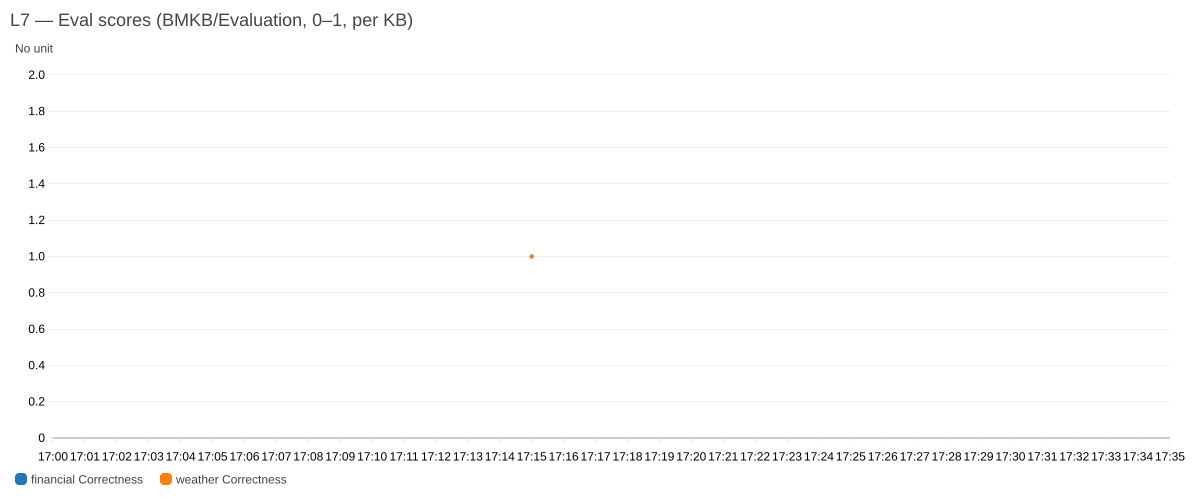
图 16:每个知识库的第 7 层按需评估分数,旁边是第 5 层 span 表
第 7 层显示每个知识库的按需评估分数,旁边是第 5 层 OTEL span 表,因此分数及其产生所依据的 span 可以在同一个面板中一并查看。
持续评估(在线): Agent 堆栈还会配置一个 AWS::BedrockAgentCore::OnlineEvaluationConfig,对实时会话进行采样并自动评分,无需运行 notebook。配置本身可在 Bedrock AgentCore 控制台中的 Assess → Evaluations → Evaluation configurations 下查看。结果会写入日志组 /aws/bedrock-agentcore/evaluations/results/<config-id>,并且每个分数也会作为 CloudWatch 指标发布到 Bedrock-AgentCore/Evaluations 命名空间中,以评估器名称和配置 id 为键,因此无需解析日志即可绘制分数图表或基于分数设置告警。
下面的截图显示了 AgentCore 控制台中的在线评估配置,路径为 Assess,然后是 Evaluations,再然后是 Evaluation configurations。
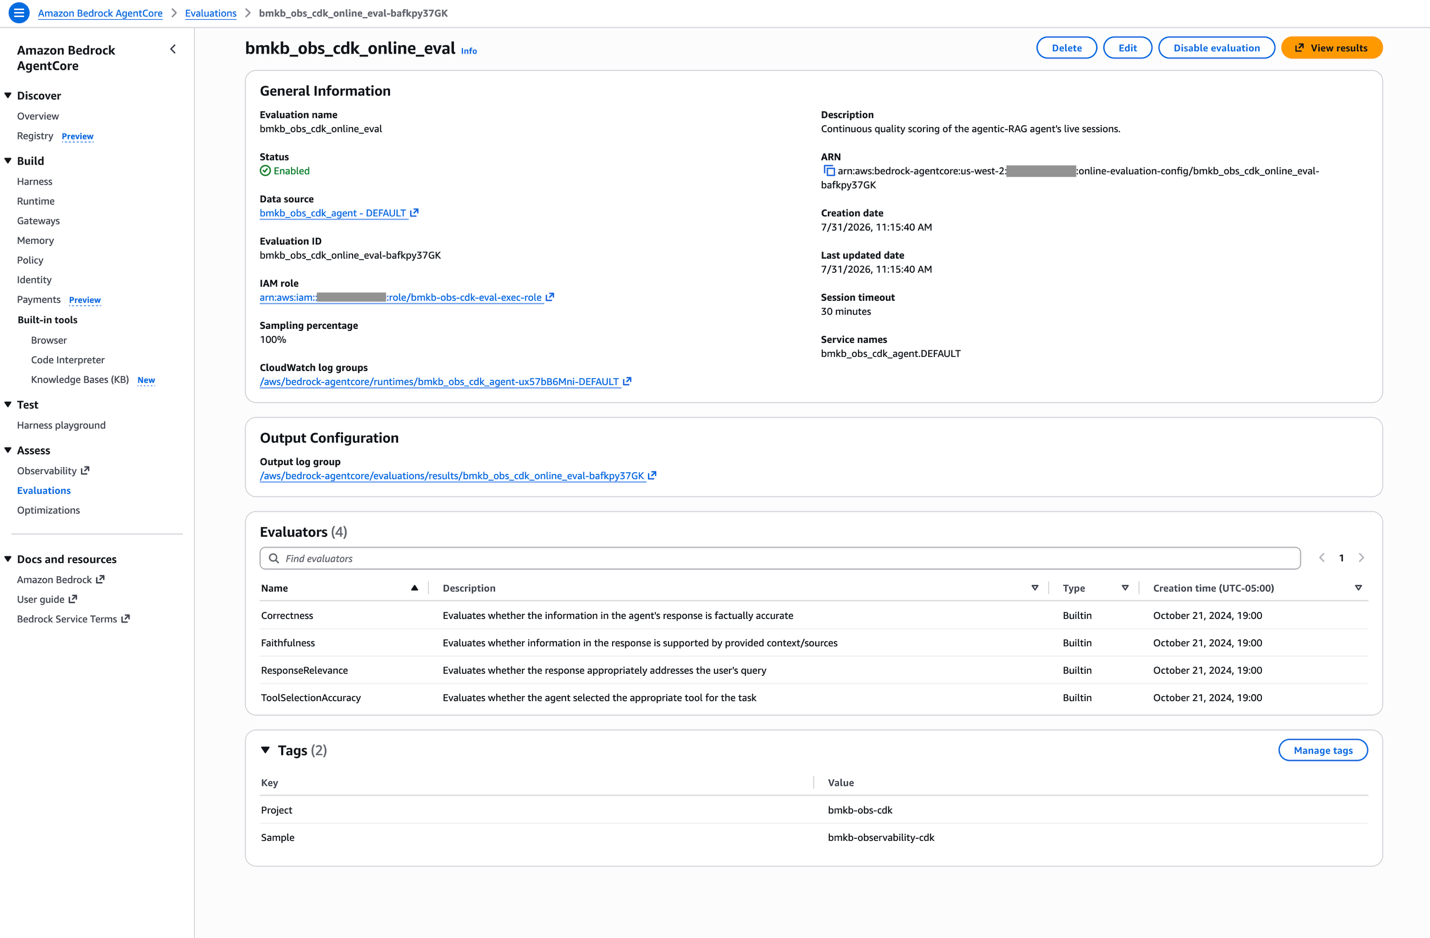
图 17:AgentCore 控制台中的在线评估配置,包含 4 个内置评估器,采样率为 100%
该配置列出了 4 个内置评估器:Tool-Selection Accuracy、Faithfulness、Correctness 和 Response Relevance,采样率均设置为 100%,并显示为 ACTIVE 且已启用。
由于这些分数是普通的 CloudWatch 指标,因此可以像其他指标一样绘制图表,无需解析日志;同一个小组件也可以配置告警。下面的截图显示了以普通 CloudWatch 指标形式绘制的这 4 个评估器分数。
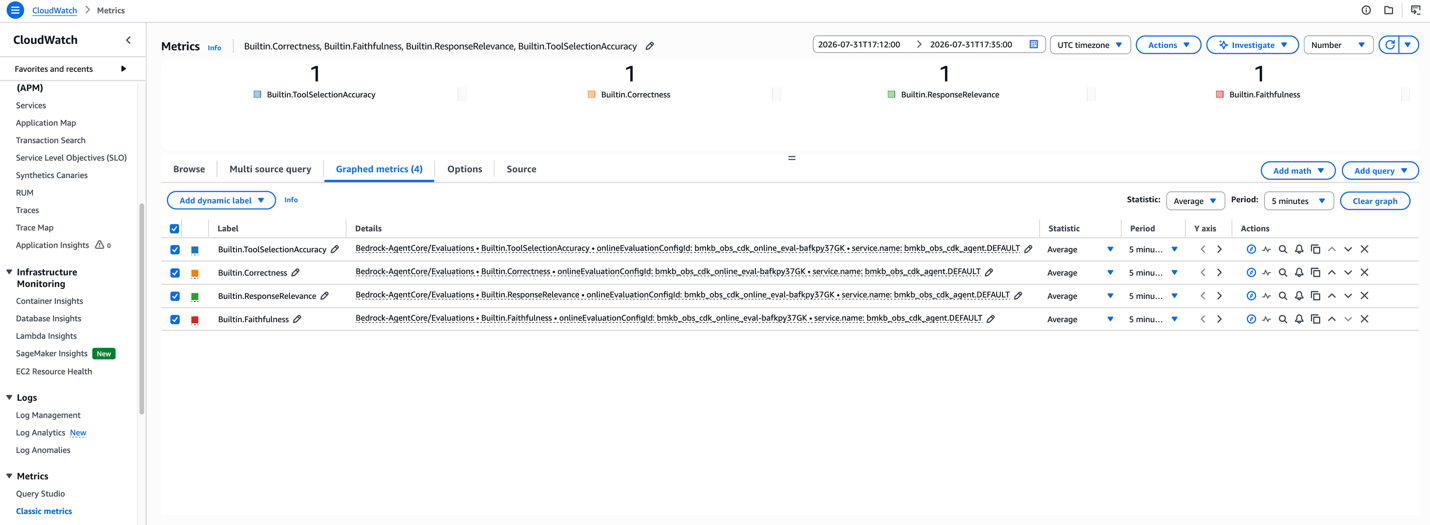
图 18:以普通 CloudWatch 指标形式绘制的 4 个持续评估器分数
这 4 个评估器分数以指标形式显示在 Bedrock-AgentCore/Evaluations 命名空间中,每个指标都以评估配置 id 和代理的服务名称为键,因此无需解析日志即可绘制图表或设置告警。
在线结果只有在会话关闭后才会出现。评分会在会话完成后运行,因此在产生流量后,结果日志组会在大约会话空闲超时时间(约 30 分钟)内保持为空。运行结束后立即看到空组是预期行为,并非配置错误。每个结果事件都带有 session.id,因此会与其他每一层关联起来。笔记本中的按需路径无需等待,这就是两者都存在的原因。
在本次运行内置的四个评估器中,连续路径在正确性、忠实度、响应相关性和工具选择准确性上均获得 1.00 分;每个评估器评分了五条追踪记录,每个结果都带有书面解释。
采样与成本。此应用将 SAMPLING_PERCENTAGE = 100 设置为 纯粹用于博客实验,因此每个会话都会被评分,结果也会立即显示。这不是生产环境建议。在线评估会为每个采样会话调用一次 LLM 评判器,因此成本会随采样率和流量规模增长。在实际部署中,应选择符合质量监控需求和预算的采样百分比,并在启用前使配置符合组织自身的策略和成本治理要求。该比率是 config.py 中的单个常量 EvalConfig.SAMPLING_PERCENTAGE。
清理
完成后,请移除该解决方案以停止产生费用,因为当这些堆栈处于空闲状态时,存储的 KB 数据、ECR 中的代理镜像以及仍处于活动状态的在线评估都会产生成本。一个命令即可全部拆除:
cdk destroy --allCDK 会自行按照反向依赖顺序删除堆栈:先删除仪表板,再删除代理,然后是网关,最后是 kb;这与它为部署推导出的依赖图相同,只是反向执行。无需维护一个与部署脚本保持一致的拆除脚本,这是一次性建模依赖关系所带来的、较为低调但很有价值的特性之一。
有两种移除行为值得了解,因为它们都可以替代手写的清理代码:
self.source_bucket = s3.Bucket(
    self, "SourceBucket",
    removal_policy=RemovalPolicy.DESTROY,
    auto_delete_objects=True,  # replaces a list_object_versions delete loop
)

self.repository = ecr.Repository(
    self, "AgentImageRepo",
    removal_policy=RemovalPolicy.DESTROY,
    empty_on_delete=True,  # replaces an image-delete loop
)
两者都已针对示例数据卫生进行了设置;对于任何重要数据,请将存储桶切换为 RemovalPolicy.RETAIN。
CDK 引导堆栈(CDKToolkit)及其暂存存储桶不会被移除。它们是账户范围内共享的基础设施,其他 CDK 应用可能依赖它们。
与单次解决方案相比有哪些变化
本文和2024 年解决方案都是使用 Python 编写的 CDK 应用,并通过 cdk deploy 部署。这里保持不变的是编写工具,变化的是底层架构,而大部分变化都是减法:
| 关注点 | 2024 年:单次 RAG | 本解决方案 |
| 向量存储 | 由你配置、扩展并按 OCU 付费的 OpenSearch Serverless 集合和索引 | 无。类型:MANAGED,Amazon Bedrock 负责存储和索引 |
| 索引生命周期 | 自定义资源创建索引,并等待索引变为可搜索状态 | 无需创建 |
| 嵌入模型 | 由你选择并授予模型访问权限 | 默认由服务管理 |
| 堆栈 | 3 个:KB 角色 → OpenSearch 基础设施 → KB + 数据源 | 4 个:kb → 网关 → 代理 → 仪表板 |
| 检索 | 一次 Retrieve,按向量相似度返回 top-k 个分块 | AgenticRetrieveStream,在内部重新排序,并返回带引用的综合答案 |
| 选择知识库 | 不适用,只有一个索引 | 代理会在两个知识库之间进行语义路由 |
| 再次查看语料库 | 单次操作中无法实现 | 代理会在回答前再次进行检索 |
| 遥测 | 未配置 | 七层、两个仪表板 |
| 评估 | 手动执行:同步、选择模型、提出问题 | 按需和连续评估,均已配置 |
| 空闲时的最低成本 | 无论是否查询,OCU 都会产生费用 | 仅存储 |
这种权衡在两个方向上都成立。一个回答单次问题的单一索引,每次查询的成本更低、推理起来更简单;当一个语料库包含答案时,这已经完全够用。如果情况并非如此,再考虑采用这种设计。
负责实际工作的 CDK 构造
这个应用的大部分工作由四个构造承担。之所以值得点名,是因为它们分别替代了原本需要手写的部分:
- Provider – 用于处理生命周期超过 AWS Lambda 函数 15 分钟上限的自定义资源。
on_event/is_complete的拆分意味着不会有任何内容在轮询循环中休眠,而向 CloudFormation 返回响应的协议由框架负责,无需在每个处理程序中都嵌入一个供应商提供的urllib回调。 - BucketDeployment – 上传语料库,使摄取自定义资源只需负责摄取。
- auto_delete_objects=True 和 empty_on_delete=True,替代了手写的
list_object_versions以及删除镜像的循环;否则堆栈甚至无法被销毁。 - repository.grant_pull_push(project) – 用一行代码授予 CodeBuild 所需的八项
ecr:*操作,并且在构造时就能确保拼写正确。
还有 Observe 部分中的类型化仪表板:使用 Metric / GraphWidget / Row 对象,而不是 DashboardBody JSON 字符串;这样一来,无效的小组件组合会从“在控制台中渲染损坏”变成“在 cdk synth 处失败”。
在开始之前,有两点 CDK 不会改变,而且都值得了解:
- 自由格式 JSON 仍使用 camelCase。
connector_parameters和parameter_values会原样传递,因此 AWS CDK 的 snake_case 到 PascalCase 转换不会应用于其中。像bucketName和inclusionPrefixes这样的键必须严格按照 API 的要求拼写,除此之外不会有任何提示,直到资源失败。 - 字符串类型的值仍然是字符串。 Observe 部分中
knowledge-base/<id>与裸值<id>之间的维度差异,对类型系统而言是不可见的。类型化构造检查的是结构,而不是语义。
这两点都不是偏好某个工具而非另一个工具的理由。它们构成了“类型化”所能带来的边界;了解边界所在,基本就是让 CDK 变得愉快而非出人意料的关键。
结论
我们在 Managed Amazon Bedrock Knowledge Base 和 AgentCore 上构建了一套完整的企业级智能体检索解决方案:多知识库语义路由、推理智能体、七层可观测性,以及按需评估和持续评估,并将全部内容作为单个 AWS CDK 应用进行了部署。
有两点值得记住。托管式知识库减少了基础设施,而不是增加基础设施:无需预置向量存储,无需创建索引并等待其就绪,也无需在系统闲置时持续累积 OCU 费用。正如 Amazon Bedrock 文档所述,它也是支持智能体检索和 AgentCore Gateway 连接器的知识库类型。而一旦检索变成智能体式, observability 就不再是可选项。这个应用预置的内容中,大约一半用于回答智能体究竟做了什么,以及答案是否足够好;对于智能体系统而言,这并不是额外负担,而是让系统可运营的关键部分。
CDK 的编写模型在各个衔接处体现了自身价值。在这一架构中,有七个值跨越堆栈边界,而每一个都是构造引用,而不是导出/导入对;这也解释了为什么不需要部署脚本、不需要拆除脚本,也不需要记住固定的执行顺序。
从这里开始,您可以将数据源指向自己的语料库,将代理置于虚拟私有云(VPC)中,根据预算和策略调整在线评估采样率,或向路由器添加更多知识库。要了解更多信息,请参阅 Amazon Bedrock 详细信息页面和 Amazon Bedrock 文档。应用、驱动 notebook 以及自包含实用工具均位于配套的 GitHub 存储库中,因此您可以将其克隆下来,并使用一条命令部署自己的副本。
作者简介

Prabhakar Chandrasekaran
Prabhakar 是 AWS Enterprise Support 的高级技术客户经理。他热衷于帮助客户在云端构建 AI 和 ML 解决方案。他还与企业客户合作,提供主动式指导和运营支持,帮助他们在使用 AWS 时提升解决方案的价值。Prabhakar 持有 8 项 AWS 认证和 7 项其他专业认证。在加入 AWS 之前,Prabhakar 拥有超过 23 年的职业经验,曾在金融服务领域担任数据工程师和项目负责人。

Siddhant Sahu
Siddhant 是 AWS 的高级产品经理,负责领导 Amazon Bedrock Managed Knowledge Base 的产品开发。他专注于构建和推出基础设施软件服务,通过完全托管的数据摄取、解析和智能代理搜索流水线,以经济高效、准确且安全的方式处理多模态、多语言企业数据,并利用混合搜索、多轮检索、工具使用和嵌入技术等业界先进能力。他的工作帮助数千家企业客户和 ISV 大规模构建代理。
来源:AWS Machine Learning Blog · aws.amazon.com